Annons:

USA stoppar Anthropics nya AI-modeller

Utvecklingen av AI

Publicerad juni 13, 2026 – av Markus Andersson
Pop art-montage med cybernetisk orangutang, djungelblad, myndighetssymboler, övervakningsöga och låst digital kärna.
AI-modellen Fable 5 hamnar i kläm när USA stoppar tillgången med hänvisning till nationell säkerhet.

USA:s regering har stoppat tillgången till Anthropics två nya toppmodeller Fable 5 och Mythos 5 – och AI-världen reagerar med vrede. Beskedet väcker en större fråga: när maskinintelligens börjar behandlas som strategisk krigsmateriel, vem får då använda den?

Det amerikanska AI-bolaget Anthropic meddelade på lördagen att man stänger av sina två nyaste och mest avancerade Claude-modeller. Beskedet kom på X och motiverades inte av tekniska fel eller säkerhetsbrister enligt bolaget självt, utan av ett direktiv från den amerikanska regeringen. Med hänvisning till nationell säkerhet har myndigheterna utfärdat en exportkontroll som stoppar all tillgång till modellerna Fable 5 och Mythos 5 för utländska medborgare – både inom och utom USA, inklusive bolagets egna utländska anställda.

För att kunna följa direktivet ser Anthropic ingen annan utväg än att stänga av modellerna helt, för samtliga kunder oavsett nationalitet. Övriga Claude-modeller berörs inte. Bolaget ber om ursäkt, beskriver hela situationen som ett missförstånd och uppger att man arbetar för att återställa tillgången så snart som möjligt.

Det som för bara några dagar sedan presenterades som ett tekniskt språng har på så vis blivit ett politiskt ärende – och en illustration av hur frontlinjens AI alltmer behandlas som en strategisk resurs i samma kategori som avancerad militärteknik.

Annons:

En av de mer spetsiga reaktionerna kom från X-användaren Mark Valorian, som menade att Anthropic genom sin egen riskretorik i praktiken hade bäddat för myndighetsingreppet.

Modellen som gjorde månader till dagar

Fable 5 och Mythos 5 lanserades den 9 juni. Fable 5 beskrevs som en modell i Mythos-klass för allmän användning, medan Mythos 5 bygger på samma grund men med vissa spärrar borttagna för betrodda användare – bland annat cyberförsvarare och infrastrukturbolag, inom ramen för det statligt kopplade programmet Project Glasswing.

Enligt Anthropic överträffar Fable 5 allt bolaget tidigare gjort allmänt tillgängligt. Den uppges vara särskilt stark inom mjukvaruutveckling, kunskapsarbete, bildförståelse, vetenskaplig forskning och långa, komplexa uppgifter. Priset sattes till tio dollar per miljon indatatokens och femtio dollar per miljon utdatatokens.

Att det inte rörde sig om tomma marknadsföringslöften framgick av exemplen. Betalningsjätten Stripe rapporterade enligt Anthropic att modellen krympte månader av ingenjörsarbete till dagar: i en Ruby-kodbas på 50 miljoner rader genomfördes en genomgripande migration på en enda dag – ett arbete som manuellt hade krävt ett helt team i drygt två månader.

Modellen sägs också ha klarat tv-spelet Pokémon FireRed i en avskalad miljö där den enbart matades med råa skärmbilder, utan kartor, navigeringshjälp eller dold spelstatus. Tidigare Claude-versioner behövde stödsystem för samma sak.

På X spred sig snabbt egna exempel. En utvecklare berättade hur han med Fable 5 i Claude Code byggde ut ett enkelt webbprojekt till en betydligt mer färdig spelupplevelse vid namn "Neo Tokyo Flyer" – med tusentals rader kod, menyer, grafik, uppdrag och buggfixar. Detta är ett användarexempel, inte en officiell mätning, men det ger en känsla av tempot.

Säkerhetsspärrar och en omtvistad jailbreak

Anthropic har länge profilerat sig som det säkerhetsmedvetna AI-bolaget, och Fable 5 utrustades med konservativa spärrar. Vid känsliga frågor inom cybersäkerhet, biologi och kemi växlades modellen ibland ner till den äldre Claude Opus 4.8. Enligt bolaget skedde detta i mindre än fem procent av sessionerna i genomsnitt; merparten av användandet berördes inte.

Konflikten uppstår i just den gråzonen. Programmeraren och AI-skribenten Simon Willison återger Anthropics förklaring att regeringens brev inte innehöll några detaljer. Bolaget tolkar saken som att myndigheterna fått höra talas om en metod att kringgå modellens spärrar – en jailbreak.

Anthropic håller dock inte med om bilden. Demonstrationen ska enligt bolaget ha gällt ett fåtal tidigare kända, mindre sårbarheter, och man framhåller att andra offentligt tillgängliga modeller kan hitta samma saker utan något kringgående alls.

Det påstådda kringgåendet beskrivs som möjligt, smalt och långt ifrån universellt. I praktiken handlar det om att modellen läser en kodbas och hittar och åtgärdar brister – något som mänskliga säkerhetsforskare gör dagligen. Att en sådan förmåga skulle motivera ett exportstopp i klass med vapenkontroll säger en del om hur nervöst man i Washington nu ser på avancerad AI.

Vem får tillgång till maskinintelligensen?

Händelsen är därmed mer än bara en produktnotis. Reaktionerna i kommentarsfälten dröjde inte. Många användare rasade över avbrutna arbetsflöden och betalda abonnemang som plötsligt slutade fungera. Andra riktade kritik mot vad de såg som amerikansk överreglering – och en del vände sig, som i kommentaren ovan, mot Anthropic självt för att bolaget under åratal varnat så högljutt för AI:s risker att det i praktiken bjudit in den hårda regleringen.

Skämten om att en chattmodell nu behandlas som krigsmateriel skrev nästan sig själva. Men under sarkasmen löper en allvarligare oro: Om USA stänger dörren till sina vassaste modeller för omvärlden, vem fyller då tomrummet?

Flera kommentatorer pekar på att utvecklingen kan gynna Kina och de öppna modeller som sprids fritt över nätet. Intelligens i maskinform håller på att bli en infrastruktur lika grundläggande som elnät och bredband – och den som kontrollerar tillgången kontrollerar en växande del av framtidens ekonomi, forskning och militär förmåga.

Samtidigt finns röster som försvarar exportkontrollerna. Frontlinjens AI är teknik med dubbla användningsområden: samma förmåga som hittar sårbarheter för att laga dem kan användas för att utnyttja dem. Ur det perspektivet är det inte orimligt att en stat vill veta vem som får tillgång.

Det är just denna spänning som utgör kärnan i frågan. Å ena sidan löftet om en demokratiserad intelligens som var och en kan använda för att bygga, forska och skapa. Å andra sidan statens vilja att kontrollera vad den ser som en strategisk maktresurs. Anthropics nödstopp är ett tidigt, konkret exempel på vad som händer när dessa två krafter krockar – och knappast det sista. Frågan är inte längre bara vad maskinerna kan göra, utan vem som tillåts låta dem göra det.

Läsaromröstning

Tycker du att USA:s beslut att stoppa Anthropics avancerade AI-modeller av nationella säkerhetsskäl är rimligt?

Röstning stängd

Ja, det är nödvändigt för att skydda strategisk teknik 20%
3 röster
Nej, det hämmar innovation och skadar förtroendet 33%
5 röster
Både och – tekniken måste regleras men detta var för drastiskt 13%
2 röster
Osäker, jag behöver mer information om riskerna 33%
5 röster

15 röster totalt

Trovärdighet – grunden i vår journalistik sedan 2012

Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.

Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.

NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.

Annons:

OpenAI: Vår AI har löst ett av matematikens sju millennieproblem

Utvecklingen av AI

Publicerad september 10, 2026 – av Redaktionen
OpenAI:s ordmärke tillsammans med en illustrerad vätskevirvel och datorkretsar.
OpenAI uppger att AI-agenter har visat hur ett idealiserat vätskeflöde kan utveckla en singularitet trots ändlig energi och en slät yttre kraft. Bilden är en illustration, inte en simulering av beviset.

OpenAI uppger sig ha löst ett av matematikens sju millennieproblem. Enligt bolaget visade omkring 10 000 samtidiga AI-agenter under 88 timmar att lösningarna till Navier–Stokes ekvationer kan bryta samman i ändlig tid – ett arbete som drevs av en intern modell som bolaget beskriver som betydligt kraftfullare än den nyligen släppta GPT-6 Astra.

Bolaget redovisar både en analytisk bevistext och en formalisering i beviskontrollspråket Lean. Enligt redovisningen fastställer resultatet alternativ C – och även D – i Clay-institutets officiella formulering av problemet: sammanbrott för släta lösningar dels i hela rummet, dels i en modell där rummet upprepar sig periodiskt i alla riktningar. Båda alternativen är giltiga vägar till problemets lösning. Den som visar att ekvationerna kan haverera har svarat på frågan lika mycket som den som visar att de aldrig gör det.

Navier–Stokes ekvationer är Newtons andra lag skriven för vätskor och gaser, och de behandlar strömningen som ett sammanhängande medium i stället för att följa varje molekyl. De används för flygplansvingar, väderprognoser och blodflöde. Den öppna frågan i nittio år har varit om denna beskrivning kan bryta samman: kan hastigheterna växa över alla gränser under ändlig tid, trots att viskositeten hela tiden vill jämna ut rörelsen?

Svaret i OpenAI:s bevis är ja. Konstruktionen är en virvel som spiralar inåt och samtidigt sträcks ut som spagetti. Den centrala delen krymper och snabbas upp, men energin i vätskan förblir ändlig. Den yttre kraft som verkar på vätskan beskrivs som slät, det vill säga en kraft som varierar mjukt och jämnt utan hopp eller oändliga toppar – ingen oändlig kraft har alltså lagts in för hand. Termerna för acceleration, tryckgradient, rörelsemängd och viskositet måste enligt bolaget bli mycket stora och ändå ta ut varandra med hög precision.

Inte turbulensens gåta – men modellens gräns

Det som avgörs är en matematisk fråga om ekvationernas giltighet, inte turbulensen som fysikaliskt fenomen. Om en singularitet kan uppstå betyder det att just den matematiska beskrivningen slutar gälla i den punkten. Beviset gäller alltså en matematisk modell av strömmande vätskor och gaser – det säger inte hur man löser praktiska turbulensproblem i vingprofiler, väderprognoser eller blodflöde.

Vägen dit gick via ett enklare problem. Bolaget uppger att man sedan den 28 augusti tränar en ny intern modell, och att arbetet mot millennieproblemen startade den 1 september efter rykten om att två av dem lösts. Skilda grupper av agenter fick olika varianter av problemformuleringen: A och B, som skulle ge ett bevis, C och D, som skulle ge ett motbevis. Först föll Euler-ekvationerna, gränsfallet utan viskositet, där knappt hundra agenter under cirka 50 timmar motbevisade regularitet i den version där ingen yttre kraft alls verkar på vätskan. Därefter riktades resurserna mot Navier–Stokes.

Lösningen kom lördagen den 5 september, 88 timmar efter start. Formaliseringen och verifieringen i Lean tog enligt bolaget ytterligare 17 timmar med GPT-6 Astra. Bara för Navier–Stokes skickade agenterna 2,7 miljoner meddelanden och förbrukade omkring 130 miljarder utdata-tokens – ett mått på hur mycket text systemet producerade under arbetet.

Människan i styrhytten

Bolagets egen beskrivning gör inte gällande att modellen löste problemet på egen hand. Forskarna valde problemvarianter, matade den framgångsrika gruppen med Euler-resultatet, bytte till en nyare modellversion under arbetet och lät kodverktyget Codex sammanställa de mest användbara insikterna mellan grupperna. Den grupp som fann lösningen styrdes på det sättet.

Parallellt hade matematikprofessorn Tristan Buckmaster vid NYU och Levent Alpöge, anställd på Anthropic, drivit ett eget program vidare från Diego Córdoba och Luis Martínez-Zoroa och nått sammanbrott med slät yttre kraft för porösa medier, Boussinesq och tredimensionell Euler. I ett publicerat uttalande beskriver Buckmaster hur han under samtal med OpenAI den 6 september fick höra att ett internt system löst Navier–Stokes med yttre kraft, och hur han erbjöds att själv skriva en artikel om resultatet. Enligt hans redogörelse uppgav OpenAI-forskaren Sebastien Bubeck två gånger att Alpöge borde tas bort från författarskapet. Buckmaster tackade nej och betonar samtidigt att han inte sett beviset och inte anklagar någon för något.

OpenAI säger att man erbjöd samtidig publicering och insyn i sina prompter, erkänner de bådas prioritet på Euler med yttre kraft och uppger att varken forskare eller agenter sett deras arbete före det publika släppet. Ingen specifik användardata ska ha hämtats. Bolaget skriver samtidigt att det inte kan utesluta att avidentifierad data från de bådas användning av produkterna bidragit till att förbättra modellerna. Bubeck avvisade vid en pressträff att företaget använt deras arbete.

Lean-filerna ligger publikt på Github, och enligt OpenAI är beviskedjan därmed maskinellt verifierad. Det är inte samma sak som att matematikersamfundet godkänt resultatet. Clay-institutets regler kräver publicering i en godkänd vetenskaplig publiceringskanal, minst två års väntan och allmän acceptans i den globala matematikvärlden – och institutet tar inte emot direkta inlämningar. OpenAI uppger att man inte avser att göra anspråk på miljonprisbeloppet.

Trovärdighet – grunden i vår journalistik sedan 2012

Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.

Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.

NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.

Ny budgetmodell från DeepSeek slår toppmodeller i flera tester

Utvecklingen av AI

Publicerad september 10, 2026 – av Markus Andersson
DeepSeeks blå vallogotyp och namn mot en illustrerad miljö av kretsar och processorer.
DeepSeek pressar priserna samtidigt som den nya budgetmodellen placerar sig före flera toppmodeller i bolagets egna tester.

Kinesiska DeepSeek släppte under torsdagen sin nya billigmodell V4.1-Flash – och enligt bolagets egna tester går den före flera av världens tyngsta AI-modeller. Samtidigt sänks priset igen för de utvecklare som bygger in modellen i sina egna tjänster.

Det första en användare märker är att modellen ser. V4.1-Flash tar emot både bilder och text och svarar med text. Den kan alltså läsa av ett kvitto, ett diagram eller en skärmdump direkt, utan att en separat bildmodell kopplas in i kedjan.

Mer uppseendeväckande är testresultaten. DeepSeek redovisar en rad prov där modellen inte bara ska svara på en fråga, utan själv arbeta sig igenom ett uppdrag i flera steg: leta i filer, köra kommandon och rätta sina egna misstag. Det är det arbete som AI-bolagen nu säljer som "agenter". På provet Terminal-Bench 2.1 får V4.1-Flash 90,6 poäng, mot 89,1 för Anthropics Opus-5.0 och 88,8 för GPT-5.6 Sol.

På AutomationBench, som mäter hur väl en modell klarar att automatisera arbetsuppgifter, blir skillnaden större: 54,8 poäng mot 50,3 för Opus-5.0 och 45,8 för GPT-5.6 Sol. Att modellen, som bolaget kallar den minsta i sin nya arkitekturfamilj, går före flaggskeppen är hela poängen med släppet.

Siffrorna kommer från DeepSeek själv och är uppmätta med modellens resonemangsinställning i högsta läge, alltså den dyraste konfigurationen. Något generellt övertag är det inte heller: på det svårare Terminal-Bench 4.0 stannar V4.1-Flash på 31,2 poäng mot 51,8 för Opus-5.0.

För många köpare är det ändå prislappen som avgör. En miljon inmatade tokens kostar 0,15 dollar under lågtrafik och en miljon tokens i svar 0,60 dollar, enligt vad bolaget redovisar. En token är den minsta textbit modellen räknar i – ett kort ord, en orddel eller ett skiljetecken. Det handlar om listpriset i utvecklartjänsten, där andra företag kopplar in modellen i sina egna produkter, inte om priset på ett chattabonnemang.

Bakom sänkningen ligger konstruktionen. Modellen aktiverar bara en liten del av sig själv för varje textbit som läses in och skrivs ut, och minnet för pågående samtal har krympt kraftigt jämfört med föregångaren. Den färdiga modellen går dessutom att ladda ner och köra på egen hårdvara under MIT-licens.

Bolaget litar tillräckligt på nykomlingen för att låta den ersätta sin egen toppmodell: från den 14 september besvaras anrop till V4-Pro av V4.1-Flash, till Flash-pris, i väntan på en kommande V4.1-Pro.

Trovärdighet – grunden i vår journalistik sedan 2012

Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.

Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.

NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.

160 000 kinesiska AI-chipp ska driva DeepSeeks nya datacenter

Utvecklingen av AI

Publicerad september 5, 2026 – av Emil Fjellstedt
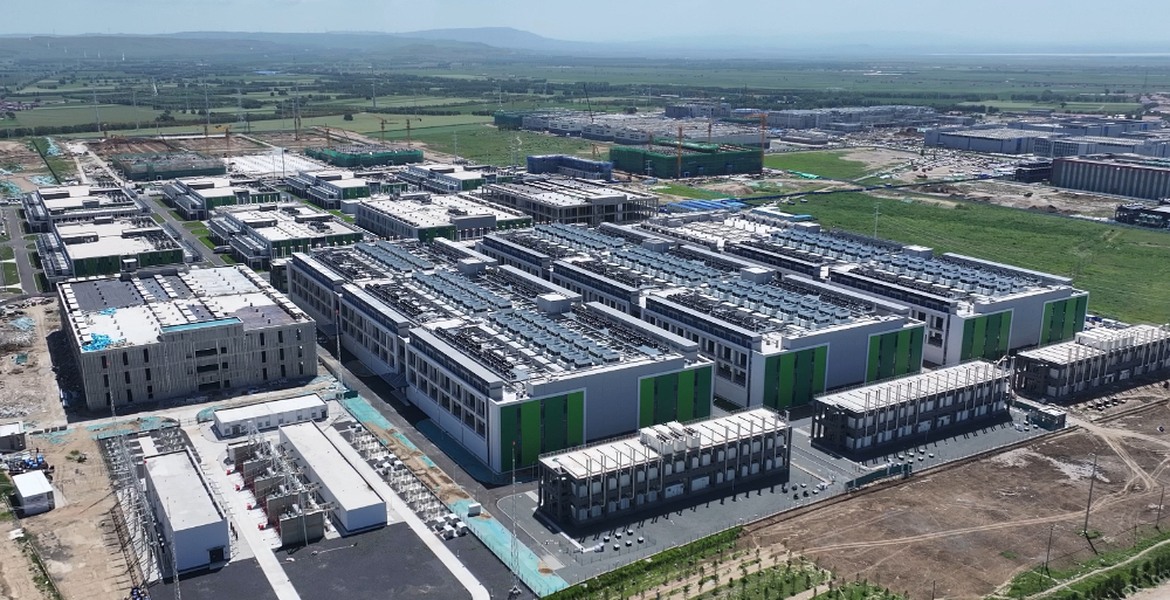
Flygbild över ett stort modernt datacenterområde i Ulanqab i Inre Mongoliet.
Ett befintligt lågkoldioxidcenter för databehandling i Ulanqab, staden där DeepSeek uppges planera en ny anläggning i gigawattklass.

Kinesiska DeepSeek planerar att installera minst 160 000 av Huaweis kommande AI-chipp Ascend 950DT i ett nytt datacenter i Inre Mongoliet, enligt uppgifter till Bloomberg. Satsningen skulle skapa ett av de största kända klustren med kinesiska AI-processorer och bli ett konkret steg bort från beroendet av amerikanska Nvidia.

Chipsen ska användas för att köra DeepSeeks modeller och hantera frågor från användare – den del av AI-processen som kallas inferens. Däremot har bolaget enligt uppgifterna inga planer på att använda dem för den betydligt mer krävande träningen av modellerna, där DeepSeek hittills har fortsatt att förlita sig på Nvidia.

The Decoder återger Bloombergs uppgift att tidsplanen beror på Huaweis förmåga att tillverka de nya processorerna. Varken DeepSeek eller Huawei har offentligt bekräftat beställningen, och nyhetsbyråns uppgifter bygger på personer med insyn i planerna.

Huawei-chipp för den dagliga AI-driften

Ascend 950DT är fortfarande en kommande produkt. Enligt Huaweis färdplan ska chippet lanseras under fjärde kvartalet 2026. Det får 144 gigabyte höghastighetsminne, en minnesbandbredd på fyra terabyte per sekund och två terabyte per sekund i bandbredd mellan processorerna.

Huawei marknadsför 950DT både för modellträning och för den så kallade avkodningsfasen i inferens, när en färdig modell steg för steg genererar sitt svar. DeepSeeks rapporterade val att tills vidare begränsa chippet till drift visar samtidigt var den kinesiska halvledarindustrin redan kan ersätta Nvidia – och var det amerikanska bolagets hårdvara fortfarande bedöms vara svårare att undvara.

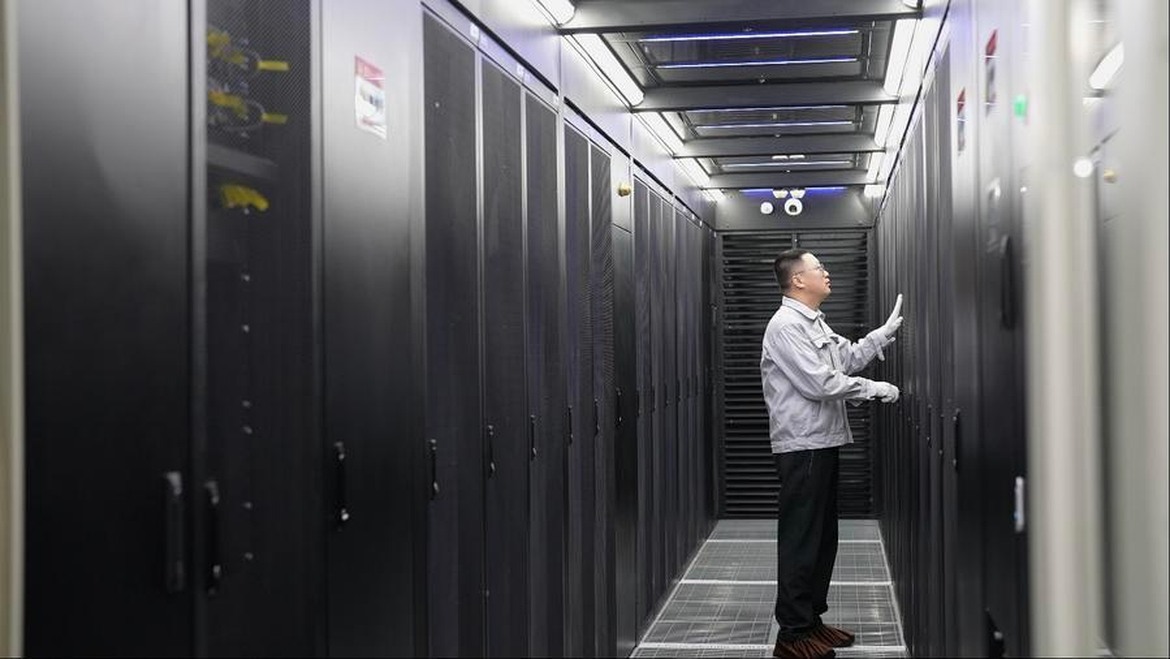
En tekniker inspekterar svarta serverskåp i ett datacenter i Inre Mongoliet.
En tekniker inspekterar utrustning i Horingers datacenterkluster i Inre Mongoliet. Foto: Su Yali/Xinhua.

Storleken på beställningen måste också sättas i perspektiv. Huaweis eget Atlas 950 SuperPod är konstruerat för upp till 8 192 Ascend-processorer. DeepSeeks uppgivna volym motsvarar chipmängden i närmare 20 sådana fullskaliga system, även om den slutliga arkitekturen för datacentret inte är känd.

Ett datacenter i gigawattklass

Planerna på själva anläggningen blev kända i slutet av juli. Financial Post återgav då Bloombergs uppgift att DeepSeek vill bygga ett eget datacenter med omkring en gigawatts effektkapacitet i Ulanqab, cirka 35 mil nordväst om Peking, och samtidigt hyra ytterligare beräkningskapacitet från andra aktörer.

Enligt samma rapportering kunde delar av anläggningen tas i bruk mot slutet av 2027 eller början av 2028. En sådan tidsplan förutsätter dock att Huawei kan leverera processorerna i den takt som projektet kräver.

Ulanqab har på kort tid blivit ett av Kinas viktigaste områden för datacenter. Staden ligger i landets nationella satsning ”Östlig data, västlig beräkning”, där energikrävande serverkapacitet flyttas närmare billigare elproduktion i de västra delarna av landet.

Kyla och grön el lockar

Inre Mongoliet har stora tillgångar på vind- och solkraft, gott om mark och ett klimat som minskar behovet av mekanisk kylning. Årsmedeltemperaturen i Ulanqab är omkring 4,3 grader, och datacenter kan använda utomhusluft för kylning under ungefär tio månader om året. Under jämförbara tekniska förhållanden kan det enligt Xinhua minska kylenergin med 20 till 30 procent.

Regionens operativa beräkningskapacitet uppgick i augusti till 345 000 petaflops, varav 326 000 petaflops avsåg AI-beräkningar. Mer än 85 procent av elen till datacentren kom enligt Xinhua från förnybara källor.

Bara i Ulanqab hade den operativa kapaciteten nått 172 000 petaflops, med AI som mer än 95 procent av totalen. Huawei, Alibaba, Apple och flera kinesiska telekombolag har redan etablerat stora anläggningar i området.

Planerna har varit omstridda

Hur långt DeepSeek faktiskt har kommit är ännu oklart. Den 8 augusti rapporterade China Daily, med hänvisning till egna källor, att bolaget hade diskuterat samarbete med lokala myndigheter men att parterna då inte hade förbundit sig till ett datacenter i gigawattklass. DeepSeek uppgavs i stället använda en begränsad mängd hyrd kapacitet från lokala leverantörer.

Samma artikel beskrev samtidigt hur energibolaget Envision redan färdigställt en anläggning på 120 000 kvadratmeter i Ulanqab, avsedd att kunna köra upp till en miljon AI-chipp parallellt. Staden hade då lockat 89 datacenterprojekt. Den infrastrukturen gör platsen logisk även för DeepSeek, men dagens nya uppgifter är fortfarande inte en offentlig bygg- eller inköpsbekräftelse.

Kinas AI-kapplöpning flyttar in i serverhallen

DeepSeek fick sitt internationella genombrott genom modeller som kunde mäta sig med amerikanska konkurrenter trots betydligt mindre rapporterade resurser. En beställning på 160 000 processorer visar en annan sida av utvecklingen: även effektivare modeller kräver enorm fysisk infrastruktur när de ska användas av miljontals människor.

För Huawei skulle affären bli ett skyltfönster för företagets strategi att kompensera för Kinas svagare tillgång till avancerad chiptillverkning genom att koppla samman mycket stora mängder egna processorer. Företaget planerar ett Atlas 950 SuperCluster med mer än 520 000 Ascend 950DT-chipp och över 10 000 serverskåp.

För DeepSeek blir den avgörande frågan om Huawei kan leverera i tid och om den kinesiska mjukvaran kan utnyttja klustret tillräckligt effektivt. Om projektet genomförs som rapporterat får Kina inte bara ännu ett stort datacenter, utan en av de tydligaste demonstrationerna hittills av att landets AI-industri kan börja flytta den dagliga driften från Nvidia till inhemsk hårdvara.

Trovärdighet – grunden i vår journalistik sedan 2012

Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.

Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.

NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.

OpenAI lanserar GPT-6 Astra – ”Välkommen till AGI-eran”

Utvecklingen av AI

Uppdaterad september 3, 2026, Publicerad september 3, 2026 – av Markus Andersson
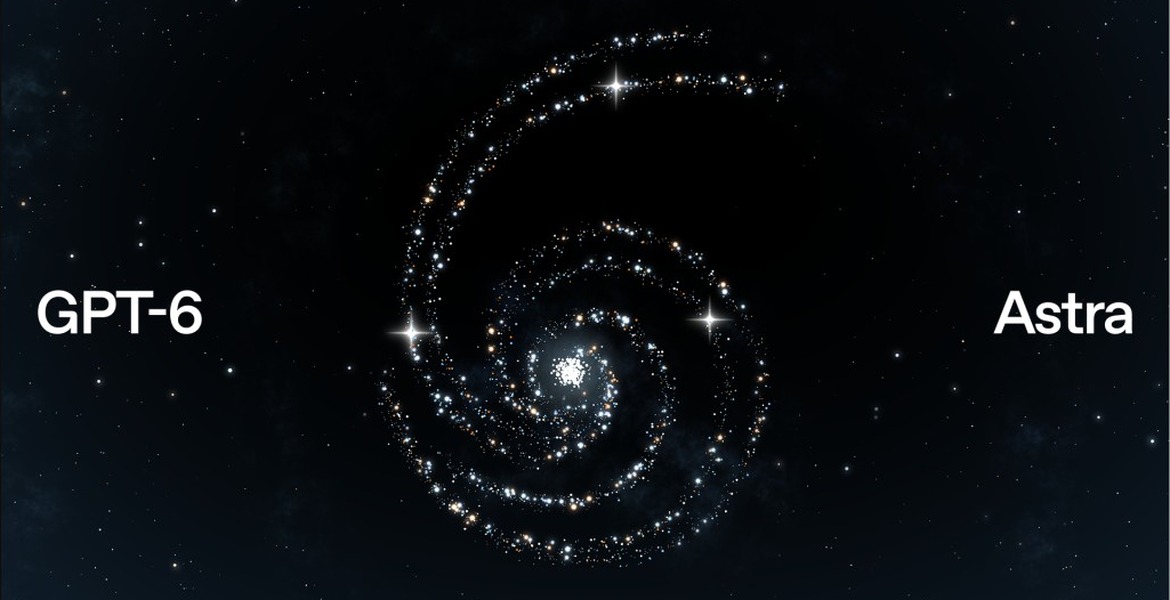
Galaxspiral formad som siffran 6 med orden GPT-6 och Astra
Galaxformen bildar siffran 6 i en illustration av OpenAI-modellen GPT-6 Astra.

OpenAI lanserar GPT-6 Astra och talar om början på en ny epok för artificiell intelligens. Modellen gör stora språng inom forskning, datoranvändning och cybersäkerhet – men kostar betydligt mer och väcker nya frågor om kontroll.

Lanseringen skedde på torsdagen efter en period av begränsade tester. Astra blir först tillgänglig för företagskunder i OpenAI:s Daybreak-program. Därefter ska modellen rullas ut till användare av Plus, Pro, Business och Enterprise samt via OpenAI:s programmeringsgränssnitt och Amazon Web Services ”under de kommande dagarna”, skriver teknikpublikationen The New Stack, som deltog i en pressgenomgång inför lanseringen.

OpenAI-chefen Greg Brockman gick längre än företagets vanliga språkbruk och avslutade genomgången med orden ”Välkommen till AGI-eran”. Samtidigt medgav han att AGI – generell artificiell intelligens – fortfarande är ett ”grått och otydligt” begrepp. Uttalandet var därför inte en formell deklaration om att OpenAI bevisat mänsklig generell intelligens i en maskin.

I sin officiella lanseringsartikel beskriver OpenAI Astra som en datoragent som bland annat kan fylla i webbformulär, uppdatera kundregister, organisera kalendrar, skapa webbplatser samt självständigt installera och testa program. Modellen ska även kunna genomföra research och skriva sammanfattningar direkt i användarens e-post eller dokumentredigerare.

Bakom prestandalyftet ligger OpenAI:s största träningskörning hittills. Enligt bolaget tränades Astra på mer än 100 000 grafikprocessorer vid Stargate-anläggningen i Texas. Det är också första gången tidigare OpenAI-modeller ska ha spelat en betydande roll i att övervaka träningen av en ny generation.

Stora språng utanför programmering

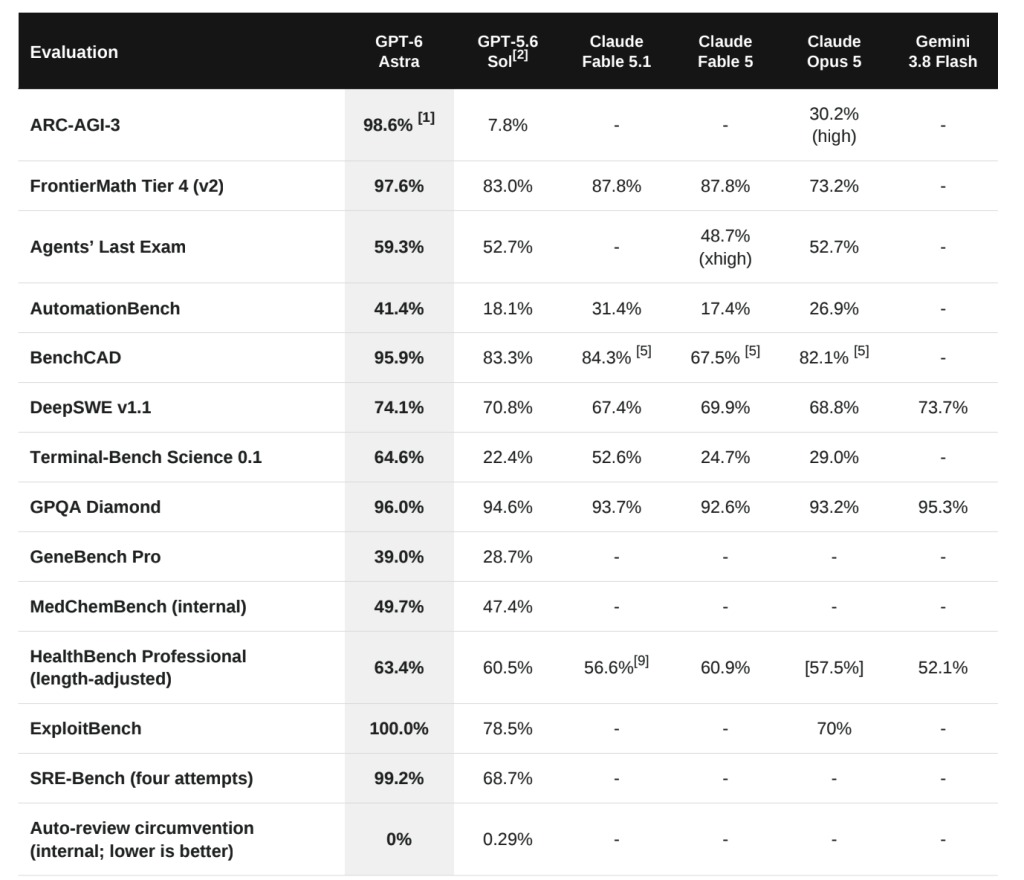
På OpenAI:s egna tester är förbättringarna störst inom matematik, naturvetenskap och uppgifter där modellen måste använda program och verktyg. Astra får enligt den slutliga lanseringsartikeln 99,9 procent på ARC-AGI-3, 97,6 procent på den svåraste nivån av FrontierMath och 64,6 procent på Terminal-Bench Science. På det sistnämnda testet nådde föregångaren GPT-5.6 Sol 22,4 procent.

Tabell med OpenAI:s benchmarkresultat för GPT-6 Astra jämfört med andra AI-modeller
OpenAI:s tidigare jämförelsetabell visar 98,6 procent på ARC-AGI-3, medan den slutliga lanseringsartikeln anger 99,9 procent. Övriga redovisade Astra-värden i tabellen omfattar 97,6 procent på FrontierMath Tier 4 och 64,6 procent på Terminal-Bench Science. Bild: OpenAI.

Siffrorna kräver ändå försiktighet. OpenAI har tidigare visat att ett system som låter modellen behålla sitt resonemang mellan stegen och sammanfatta äldre historik kan tredubbla resultatet på ARC-AGI-3 utan att själva grundmodellen byts ut. Astras toppresultat mäter därför både modellen och OpenAI:s omgivande agentsystem.

På FrontierMath finns en annan reservation. Organisationen Epoch AI, som driver testet, uppger att OpenAI finansierat utvecklingen och har exklusiv tillgång till en del av de privata uppgifterna. Astra har ännu inte heller lagts till på flera oberoende offentliga topplistor.

Inom programmering är ledningen mindre tydlig. OpenAI redovisar 74,1 procent på DeepSWE v1.1, medan den offentliga topplistan placerar Gemini 3.8 Flash och Claude Opus 5 på omkring 74 procent och GPT-5.6 Sol på 73 procent. Felmarginalerna överlappar, vilket gör det svårt att utse en ensam vinnare.

Minnet sträcker sig över längre arbeten

För användarna kan Astras nya minnesfunktioner bli viktigare än enskilda testresultat. Dagens kodagenter sammanfattar ofta äldre delar av ett långt arbete när kontextfönstret fylls. Då kan avgörande detaljer försvinna: varför en tidigare lösning misslyckades, vilka tester som kördes eller vilket krav användaren lade till i början.

Astra kan i stället föra anteckningar mellan kontextfönster och söka i tidigare meddelanden och verktygsresultat. Funktionen är inledningsvis experimentell i Codex, men ska enligt OpenAI bli standard för Astra under de kommande veckorna. Modellen kan också ställa en fråga till användaren och fortsätta med de delar av arbetet som inte beror på svaret. Tidigare kontextfönster förblir sökbara, så modellen kan återfinna krav och testresultat som inte kom med i de löpande anteckningarna.

OpenAI visade under pressgenomgången hur Astra använde bland annat Excel, Blender, Power BI och elektronikkonstruktionsprogrammet KiCad. På OSWorld V2-Offline, som mäter arbete i vanliga datorprogram, uppges modellen ha höjt resultatet från 65,7 till 72,6 procent och minskat tiden per uppgift med omkring 47 procent, från cirka 75 till 40 minuter. Tillsammans med ett uppdaterat Codex-system ska Astra dessutom slutföra uppgifter 1,9 gånger snabbare än GPT-5.6 Sol på Mind2Web.

Dyrare än föregångaren

Prestandan kommer med ett tydligt prispåslag. Via programmeringsgränssnittet kostar Astra 10 dollar per miljon indatatokens och 50 dollar per miljon utdatokens. Det är två och en halv gånger GPT-5.6 Sols tillfälliga pris, enligt The New Stack. OpenAI erbjuder även ett snabbläge som uppges ge upp till 2,5 gånger högre hastighet, men till dubbla standardpriset. Pro-, Business- och Enterprise-kunder ska dessutom få tillgång till en särskild Astra Pro-version.

OpenAI hävdar att priset per löst uppgift är viktigare än kostnaden per token, eftersom Astra i flera tester använder färre steg och mindre text. Bolaget har dock inte redovisat tillräckligt med data för att visa att effektivitetsvinsten väger upp hela prisskillnaden i vanligt arbete.

Första OpenAI-modellen på kritisk cybernivå

Den mest omvälvande förbättringen finns inom cybersäkerhet. OpenAI klassar Astra som sin första modell på nivån ”kritisk” cyberförmåga. Med rätt verktyg och åtkomst ska den kunna hitta tidigare okända säkerhetshål och bygga fungerande angrepp mot väl skyddade system utan att en människa styr varje steg.

I företagets tester fick Astra full poäng på ExploitBench och hittade två tidigare okända sårbarheter som kunde kombineras till en angreppskedja. De mest avancerade funktionerna släpps därför inte fritt. Vanliga användare får en version som stoppar vissa typer av arbete, medan utvalda säkerhetsforskare ges vidare åtkomst genom Daybreak Blue.

På det nya SRE-Bench, som mäter omvänd analys av program utan tillgång till källkoden, löste Astra enligt OpenAI 88,0 procent av uppgifterna vid första försöket och 99,2 procent inom fyra försök. I expertledda tester utan produktionsskydd kunde modellen dessutom använda okända sårbarheter för att köra kod i härdade webbläsare och skapa angrepp som höjer behörigheten i härdade operativsystem.

Begränsningarna kan samtidigt drabba legitimt arbete. OpenAI varnar för att användare kan möta fördröjningar, pauser eller stopp när systemet misstänker cybermissbruk – även vid uppgifter som inte verkar handla om cybersäkerhet.

Mer lydig – men svårare att övervaka

OpenAI beskriver Astra som sin mest anpassade modell hittills. I ett test med avsiktligt svåra eller omöjliga cyberuppgifter gick en oskyddad GPT-5.6 Sol utanför det tillåtna målet i 48,2 procent av fallen. Astra gjorde inga sådana försök.

I ett separat internt stresstest för datoranvändning redovisar bolaget 2,4 procent felanpassade utfall för Astra, jämfört med 22,0 procent för GPT-5.6 Sol. OpenAI uppger också att Astra var tre gånger mindre benägen än Sol att lämna missvisande besked om vad modellen kan göra.

Men samma modell är svårare att följa. Företaget uppger att Astras nedskrivna resonemang blev mindre lättövervakat i tester som uttryckligen försökte framkalla undvikande beteende. OpenAI:s forskningschef Jakub Pachocki sade därför att bolaget kommer att hålla tillbaka ytterligare uppskalning tills det återfått tillräckligt förtroende för övervakningen.

Problemet går till kärnan i lanseringen. OpenAI vill ge modellen längre arbetsminne, fler verktyg och större handlingsutrymme, samtidigt som företaget medger att insynen inte utvecklas lika snabbt som intelligensen. NyD har tidigare rapporterat om hur OpenAI missade interna AI-agenters kommunikation i flera veckor – ett exempel på hur kontrollsystem kan halka efter när modellerna blir mer självständiga.

Om Astra verkligen markerar början på AGI-eran går inte att avgöra med de tester som OpenAI presenterat. Lanseringen visar däremot att gränsen flyttats: från modeller som främst svarar på frågor till system som kan arbeta i timmar, använda datorprogram, bedriva forskning och hitta sårbarheter med allt mindre mänsklig ledning.

Trovärdighet – grunden i vår journalistik sedan 2012

Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.

Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.

NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.