Strängnäs kommun står inför en av de största investeringarna i sin historia när Brookfield Asset Management (BAM) planerar att bygga ett av Europas största datacenter för artificiell intelligens (AI) i staden.
Datacentret, som ska byggas på en yta om cirka 350 000 kvadratmeter, kommer att ha en kapacitet på 750 megawatt – mer än dubbelt så stort som tidigare planerat. Projektet förväntas skapa över 1 000 permanenta jobb och cirka 2 000 arbetstillfällen under byggfasen.
Investeringen uppgår till cirka 95 miljarder kronor (omkring 10 miljarder dollar) och väntas pågå under 10–15 år.
– Strängnäs har alla förutsättningar att bli platsen för norra Europas första AI-center. Vi erbjuder en utmärkt geografisk placering, hög utbildningsnivå och gott samarbete med kommunerna i Mälardalen, säger Jacob Högfeldt (M), kommunstyrelsens ordförande i Strängnäs, till Datacenter-Forum.
Annons:
Brookfields europeiska chef, Sikander Rashid, lyfter fram vikten av att investera i AI-infrastruktur i stor skala.
– För att vara konkurrenskraftiga inom AI-utveckling och ta tillvara på dess ekonomiska potential är det avgörande att satsa stort på infrastrukturen bakom tekniken. Det handlar inte bara om datacenter, utan även om dataöverföring, lagring av chip och energiproduktion.
Strängnäs del av en bredare strategi
Satsningen i Strängnäs är en del av Brookfields bredare strategi att investera cirka 20 miljarder euro i AI-infrastruktur i Europa, där man även planerar stora datacenter i Frankrike och andra länder.
Sveriges statsminister Ulf Kristersson uttrycker sitt stöd för investeringen på sociala medier och framhåller att Sverige har en lång tradition av starka företag.
Sverige har en lång tradition av innovation och starka företag.
AI är en oerhörd kraft för att Sverige ska fortsätta vara ett land i framkant. Det är därför regeringen nu tar fram en samlad AI-strategi – och orsaken till att vi tillsatte AI-kommissionen. Nu ser vi resultat.
Sverige har konkurrensfördelar som gör landet attraktivt för stora datacenterinvesteringar, bland annat en relativt stabil energiförsörjning, hög digital mognad och närhet till akademiska nav som KTH och Uppsala universitet.
Dessutom ställer EU:s dataskyddsregler krav på att känslig data ska lagras inom unionens gränser, vilket ökar efterfrågan på lokala datacenter.
Satsningen på AI-centret kan komma att göra Strängnäs till en central nod i Europas AI-ekosystem, och bidra till att stärka Sveriges roll i den globala AI-kapplöpningen.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Artificiell intelligens kan förändra världen och ändå vara en av de största finansiella bubblorna i modern tid. Bakom den lilla textrutan byggs en tung industri av datacenter, skulder och cirkulär finansiering – och när notan kommer kan den spridas långt utanför teknikbolagen, skriver Reza Nasouri i en gästanalys.
Uppdaterad Idag kl 19:46,
Publicerad Idag 17:34
Illustration: Reza Nasouri
AI-boomen lovar en ny teknisk epok, men vilar också på datacenter, kapitalflöden och systemrisk.
Detta är en opinionstext. Artikelförfattaren svarar för de åsikter som uttrycks i artikeln.
För många människor har artificiell intelligens på bara några år blivit nästan synonymt med ChatGPT. Man skriver en fråga i en ruta, några sekunder senare kommer ett svar och någonstans där inne finns ”AI”.
Men ChatGPT är inte AI på samma sätt som en bil inte är samma sak som hela transportsektorn.
Det vi i dagligt tal ofta kallar AI består i själva verket av en mängd olika tekniker som är utvecklade för helt olika uppgifter. ChatGPT, Claude, Gemini och liknande tjänster bygger till stor del på LLM:er (stora språkmodeller). De har tränats på enorma mängder text för att lära sig mönster i språk och kan därför skriva, sammanfatta, översätta, programmera och resonera kring sådant som går att uttrycka i språk.
AI är inte ChatGPT
Men mycket av den AI som redan omger oss fungerar på andra sätt.
Annons:
När ett system analyserar en röntgenbild för att upptäcka en tumör behöver det inte vara en språkmodell. När en självkörande bil försöker avgöra om objektet framför bilen är en fotgängare, en cykel eller en plastpåse används andra typer av modeller och sensorer. När Netflix gissar vilken film du vill se, när ett banksystem letar efter bedrägerier eller när ett robotsystem lär sig gripa ett föremål är det också AI – men inte nödvändigtvis någonting som liknar ChatGPT.
Detsamma gäller några av de mest uppmärksammade vetenskapliga framstegen. Ett AI-system som förutser hur ett protein veckar sig är inte bara ”ChatGPT fast för proteiner”. Robotik, datorseende, förstärkningsinlärning, rekommendationssystem och språkmodeller är olika grenar på ett mycket större träd.
Dessutom kombineras de allt oftare.
En framtida humanoid robot kan exempelvis använda en språkmodell för att förstå instruktionen ”hämta den röda koppen i köket”, ett visionsystem för att hitta koppen, ett annat system för att beräkna hur armen ska röra sig och ytterligare programvara för balans, navigering och säkerhet. Att beskriva hela roboten som en LLM vore ungefär som att beskriva en modern bil som ”en motor”.
Den skillnaden kan låta teknisk, men den blir avgörande när man försöker förstå AI-boomen.
När någon säger att ”AI kan upptäcka cancer”, ”AI kan köra en bil” eller ”AI kommer att revolutionera robotiken” används detta ofta som ytterligare bevis för hur snabbt AI-utvecklingen går. Det kan vara helt riktigt. Men det innebär inte automatiskt att samma teknik som driver ChatGPT kommer att göra allt detta – och framför allt säger det inte att varje investering i stora språkmodeller eller gigantiska datacenter kommer att bli lönsam.
Det är här tre bokstäver börjar skapa förvirring.
AI är ett område. LLM är en teknikfamilj inom detta område. ChatGPT är en produkt byggd kring sådana modeller.
När den skillnaden väl är tydlig blir det också lättare att förstå resten av AI-ekonomin. För den stora investeringsvåg som just nu sveper över Silicon Valley handlar inte om ”all AI” på samma sätt. En mycket stor del av de nya AI-datacentren och miljardinvesteringarna drivs av kapplöpningen kring generativ AI, stora modeller och de tjänster och automatiserade arbetsflöden som byggs ovanpå dem.
Det betyder inte att AI-boomen är inbillad.
Det betyder att vi först måste veta vilken AI vi egentligen talar om innan vi kan börja fråga vad den är värd.
Den lilla textrutan och fabriken bakom
Det märkligaste med moderna AI-tjänster är kanske hur obetydliga de ser ut. På skärmen finns en textruta. Du skriver en fråga, trycker på Enter och några sekunder senare kommer ett svar. Det kan kännas ungefär lika resurskrävande som att göra en vanlig sökning på nätet.
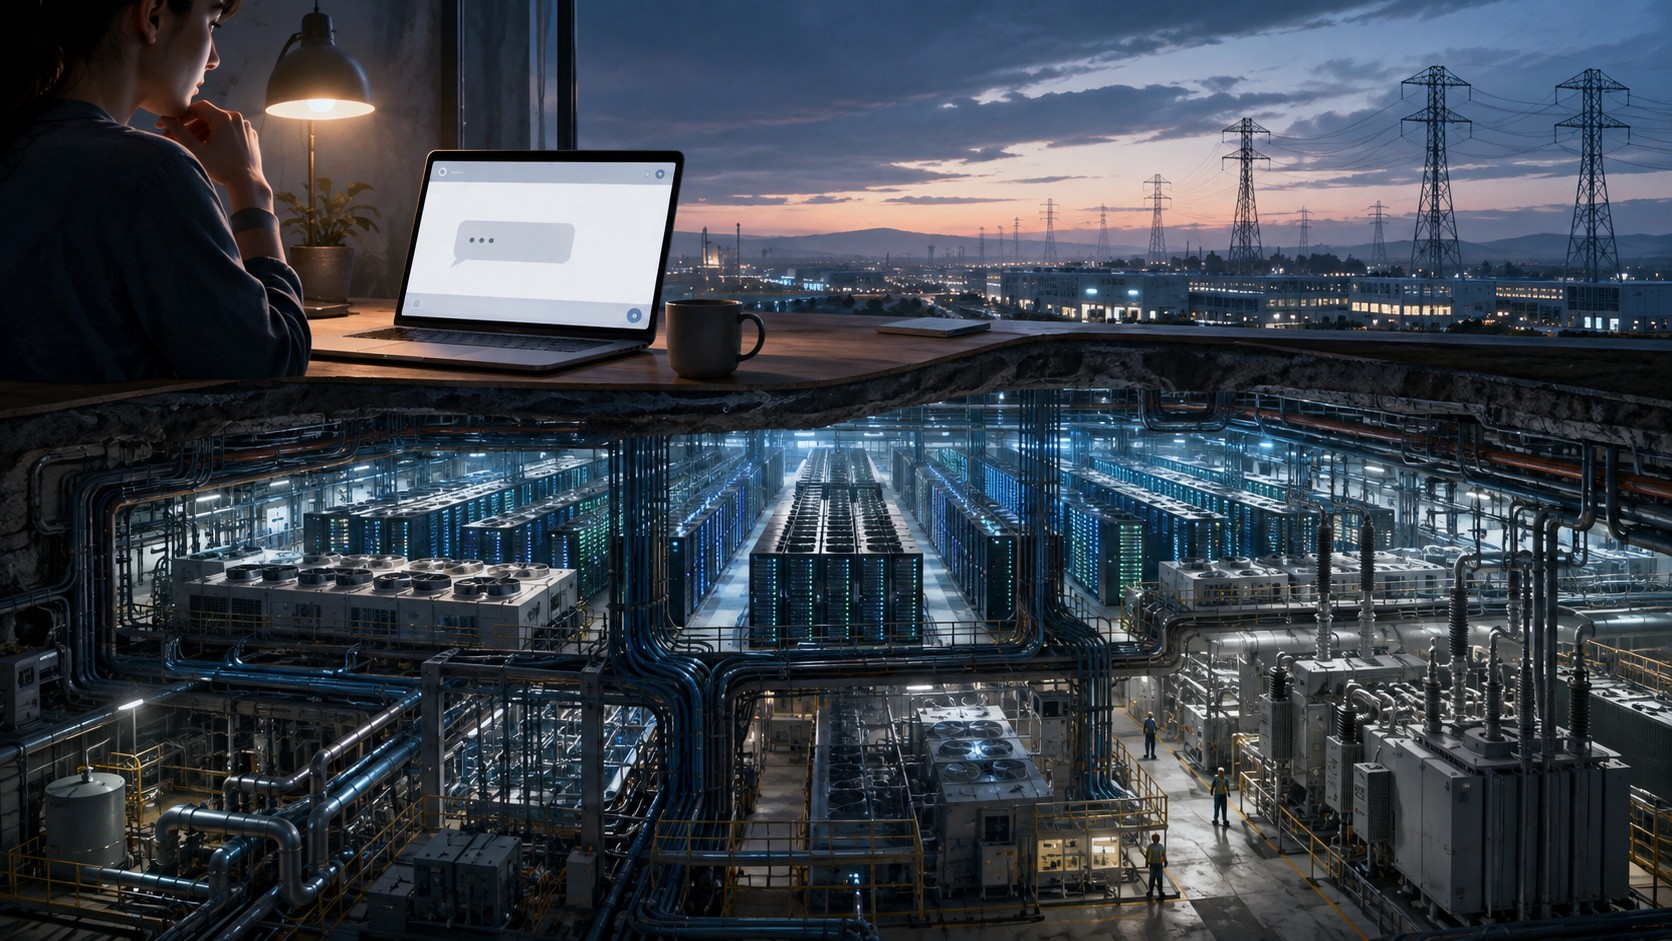
Den lilla textrutan ser viktlös ut – men bakom den finns datacenter, elkraft och kylsystem. Illustration: Reza Nasouri.
Men den lilla textrutan är bara skyltfönstret. Bakom den finns en snabbt växande fysisk industri av en typ som mjukvaruvärlden tidigare sällan behövt bygga.
Stora språkmodeller tränas och körs på avancerade acceleratorer, framför allt GPU:er (grafikprocessorer – chip som ursprungligen utvecklades för kraftfulla datorspel). En enda sådan krets kan kosta lika mycket som en bättre bil. De största anläggningarna använder redan hundratusentals GPU:er, och projekt finns med planer på upp till omkring en miljon i samma AI-komplex.
Sedan kommer resten: kraftförsörjning, transformatorer, reservkraft, kylsystem, vatten, fiberanslutningar, mark, byggnader och personal. Ett AI-datacenter är därför inte bara en hall fylld med datorer. Det börjar allt mer likna en kombination av kraftintensiv industri, telekommunikationsnod och jättelik dator.
Det är först när man ser den fysiska sidan som de astronomiska beloppen börjar bli begripliga. OpenAI räknar enligt företagets egna uppgifter med att spendera omkring 50 miljarder dollar på beräkningskapacitet under 2026 – och anser samtidigt att man fortfarande har för lite kapacitet. Microsoft, Amazon, Google, Meta, Oracle, Nvidia och en växande skara datacenterbolag bygger parallellt ut samma grundläggande infrastruktur.
Detta är också orsaken till att ordet ”compute”, beräkningskapacitet, återkommer så ofta i AI-världen. För ett vanligt mjukvaruföretag kan nästa miljon användare vara dyr att skaffa men billig att betjäna. För generativ AI innebär varje ny användare också nya beräkningar. Varje fråga, varje bild, varje kodgranskning och varje automatiserat AI-arbetsflöde förbrukar maskintid.
Det betyder inte att varje AI-fråga är dyr. Kostnaden per uppgift kan falla snabbt när hårdvara och modeller blir effektivare. Men när hundratals miljoner människor och företag samtidigt börjar låta AI skriva, analysera, programmera och arbeta automatiskt multipliceras även små kostnader till enorma infrastruktursiffror.
Här finns en av de första paradoxer som präglar hela AI-boomen. Tekniken säljs som mjukvara, men expansionen börjar likna tung industri. Företagen konkurrerar inte längre bara om vem som har den bästa algoritmen. De konkurrerar om chip, el, mark, nätanslutningar och i praktiken om vem som kan bygga den största maskinen.
Det är också därför diskussionen om AI-bubblan inte kan reduceras till om ChatGPT är bra eller dåligt. Bakom den användbara tjänsten finns investeringar som måste betala sig under många år framåt. Frågan är inte bara om människor tycker om AI. Frågan är hur mycket ekonomiskt värde som måste skapas för att finansiera infrastrukturen bakom den.
AI ser ut som mjukvara på skärmen – men bakom den håller en ny tung industri på att byggas.
När ett datacenter blir stort som en stadsdel
Det är svårt att förstå AI-boomens skala genom ord som ”serverhall” och ”datacenter”. De låter fortfarande som teknikutrymmen. De största nya anläggningarna är något helt annat: industriområden i kraftverksskala.
Hyperion i Louisiana är ett exempel. Projektet byggs ut mot fem gigawatt datorkapacitet och nästan en miljon kvadratmeter byggnadsyta. Efter ytterligare markköp omfattar området omkring 3 650 acres – nära 15 kvadratkilometer.
Som svensk jämförelse är själva markområdet drygt två och en halv gånger så stort som Södermalm i Stockholm.
Vi talar alltså inte längre om en byggnad med datorer, utan om ett industriområde större än flera svenska stadsdelar.
Effektbehovet är ännu mer svårbegripligt. OpenAI har tecknat avtal om omkring åtta gigawatt effekt enbart till datorerna i det planerade PORTS-Pike-campuset i Ohio. Det är ungefär två och en halv gånger den sammanlagda elektriska effekten från Forsmarks tre kärnreaktorer.
För att försörja området planeras tio gigawatt ny elproduktion. Av detta ska 9,2 gigawatt komma från nya naturgasanläggningar. Tio gigawatt motsvarar nästan sju reaktorer av Oskarshamn 3:s storlek.
Ett enda planerat AI-campus kan alltså behöva mer än dubbelt så stor effekt som hela Forsmarks kärnkraftverk.
Det här är inte ett isolerat amerikanskt fenomen. Internationella energiorganet IEA uppskattar att världens datacenter använde omkring 485 terawattimmar el under 2025. Till 2030 väntas förbrukningen nästan fördubblas till omkring 950 terawattimmar – ungefär lika mycket el som Japan använder i dag. AI-inriktade datacenter väntas växa betydligt snabbare än datacentersektorn i övrigt.
I USA är förändringen ännu tydligare. Berkeley Lab uppskattar att datacenter omkring 2030 kan stå för omkring 12 procent av landets totala elförbrukning, med ett osäkerhetsintervall på ungefär 9,5 till 15 procent.
Och nästan all el som går in i servrarna blir till värme. Den måste transporteras bort. Därför behövs enorma kylsystem, och på många platser även stora mängder vatten.
Amerikanska datacenter förbrukade omkring 65 miljarder liter vatten direkt på anläggningarna under 2023, enligt Berkeley Lab. Till 2028 pekar Berkeley Labs scenarier mot ungefär 145–275 miljarder liter per år. Till detta kommer den indirekta vattenåtgången för att producera elektriciteten. Skillnaderna mellan olika datacenter är samtidigt stora: moderna slutna vätskekylsystem kan använda betydligt mindre vatten än traditionella kyltorn.
Miljöpåverkan beror därför mycket på hur elen produceras och hur kylningen är byggd. Förnybar energi väntas stå för en stor del av den globala ökningen, enligt IEA. Teknikbolagen investerar även i kärnkraft, batterier och andra lösningar. Men AI-kapplöpningen går snabbare än många elnät och nya kärnkraftsprojekt hinner byggas. I flera av USA:s största satsningar fylls gapet därför med ny naturgas i gigawattskala.
Detta är viktigt för bubbeldebatten eftersom investeringarna inte är abstrakta siffror på en skärm. De blir mark, kraftledningar, transformatorer, gasturbiner, kylsystem, vägar, byggnader och hundratusentals eller miljontals avancerade chip.
Om framtidens AI-efterfrågan blir mindre än prognoserna försvinner inte dessa investeringar. Då står den fysiska infrastrukturen fortfarande kvar – och någon måste betala för den.
Vem betalar egentligen för AI?
Om du betalar några hundralappar i månaden för en AI-tjänst är det naturligt att tänka att det också ungefär är vad tjänsten kostar att leverera. Så fungerar de flesta digitala abonnemang vi vant oss vid. Netflix behöver inte spela in en ny film varje gång du trycker på Play och Spotify behöver inte hyra en orkester varje gång du lyssnar på en låt.
Generativ AI fungerar annorlunda. När du använder en språkmodell måste den faktiskt göra nya beräkningar för just din fråga. Ju större modell, ju längre dokument, ju mer avancerat resonemang och ju fler automatiserade steg som krävs, desto mer beräkningskapacitet förbrukas.
Därför finns det två priser som lätt blandas ihop: vad kunden betalar och vad användningen faktiskt kostar att producera.
För en vanlig användare syns den skillnaden nästan inte alls. Man betalar ett fast månadspris och använder tjänsten tills någon form av gräns träder in. En person som ställer några korta frågor kan vara billig att betjäna. En annan kan under samma abonnemang analysera stora dokument, generera programkod hela dagen och låta avancerade modeller resonera i långa kedjor. Kostnaden för de två användarna kan vara dramatiskt olika trots att abonnemanget kostar lika mycket.
Detta är inget märkligt i uppbyggnaden av en ny marknad. Företag subventionerar ofta en produkt i början för att få användare, skapa vanor och vinna marknadsandelar. Uber subventionerade resor. Streamingföretag har sålt tjänster billigare än vad deras långsiktiga ekonomi egentligen tålde. Mobiloperatörer har lockat kunder med telefoner som betalats tillbaka över tid.
Men för AI blir frågan större därför att hela investeringsboomen bygger på antagandet att dagens enorma användning så småningom ska omvandlas till enorma och lönsamma intäkter.
Här måste man skilja på användning och betalningsvilja. Om en restaurang säljer en middag för 50 kronor som kostar 300 kronor att laga kan restaurangen snabbt bli stadens populäraste. Kön utanför dörren bevisar att människor tycker om maten. Den bevisar inte att samma människor kommer tillbaka om priset höjs till den nivå som krävs för att restaurangen ska överleva.
Samma fråga hänger över AI-ekonomin: Hur mycket av användningen finns kvar när varje företag och varje tung användare faktiskt måste bära den fulla kostnaden?
Företagsmarknaden blir därför särskilt viktig. Ett företag som låter tusentals anställda använda AI varje dag kan snabbt gå från ett bekvämt abonnemang till en betydande löpande kostnad när användningen mäts i tokens (små textenheter som modellen räknar), API-anrop och automatiserat AI-arbete. Då räcker det inte längre att en anställd säger att AI känns fantastiskt. Ekonomichefen vill veta hur mycket tid som sparas, vad arbetet kostar och om investeringen faktiskt ökar intäkter eller minskar andra kostnader.
Det kan mycket väl visa sig att svaret blir ett rungande ja. AI kan skapa så stora produktivitetsvinster att företag gärna betalar betydligt mer än i dag. Men det är ännu ett antagande som måste bli verklighet för att den stora AI-ekonomin ska hålla.
Och därför är miljontals användare, miljarder frågor och rekordstor trafik inte samma sak som ett bevis på en hållbar affärsmodell. De visar att människor vill använda tekniken. Den verkliga ekonomiska prövningen börjar när frågan blir: vad är de beredda att betala för den?
Stor användning visar att människor vill ha AI. Den visar inte automatiskt att de är beredda att betala vad AI faktiskt kostar.
När säljaren finansierar sin egen kund
Föreställ dig en livsmedelsbutik som investerar tio miljoner kronor i restaurangen bredvid. Restaurangen använder en stor del av pengarna till att köpa sina råvaror från just den livsmedelsbutiken. Butiken kan nu visa kraftigt ökande försäljning.
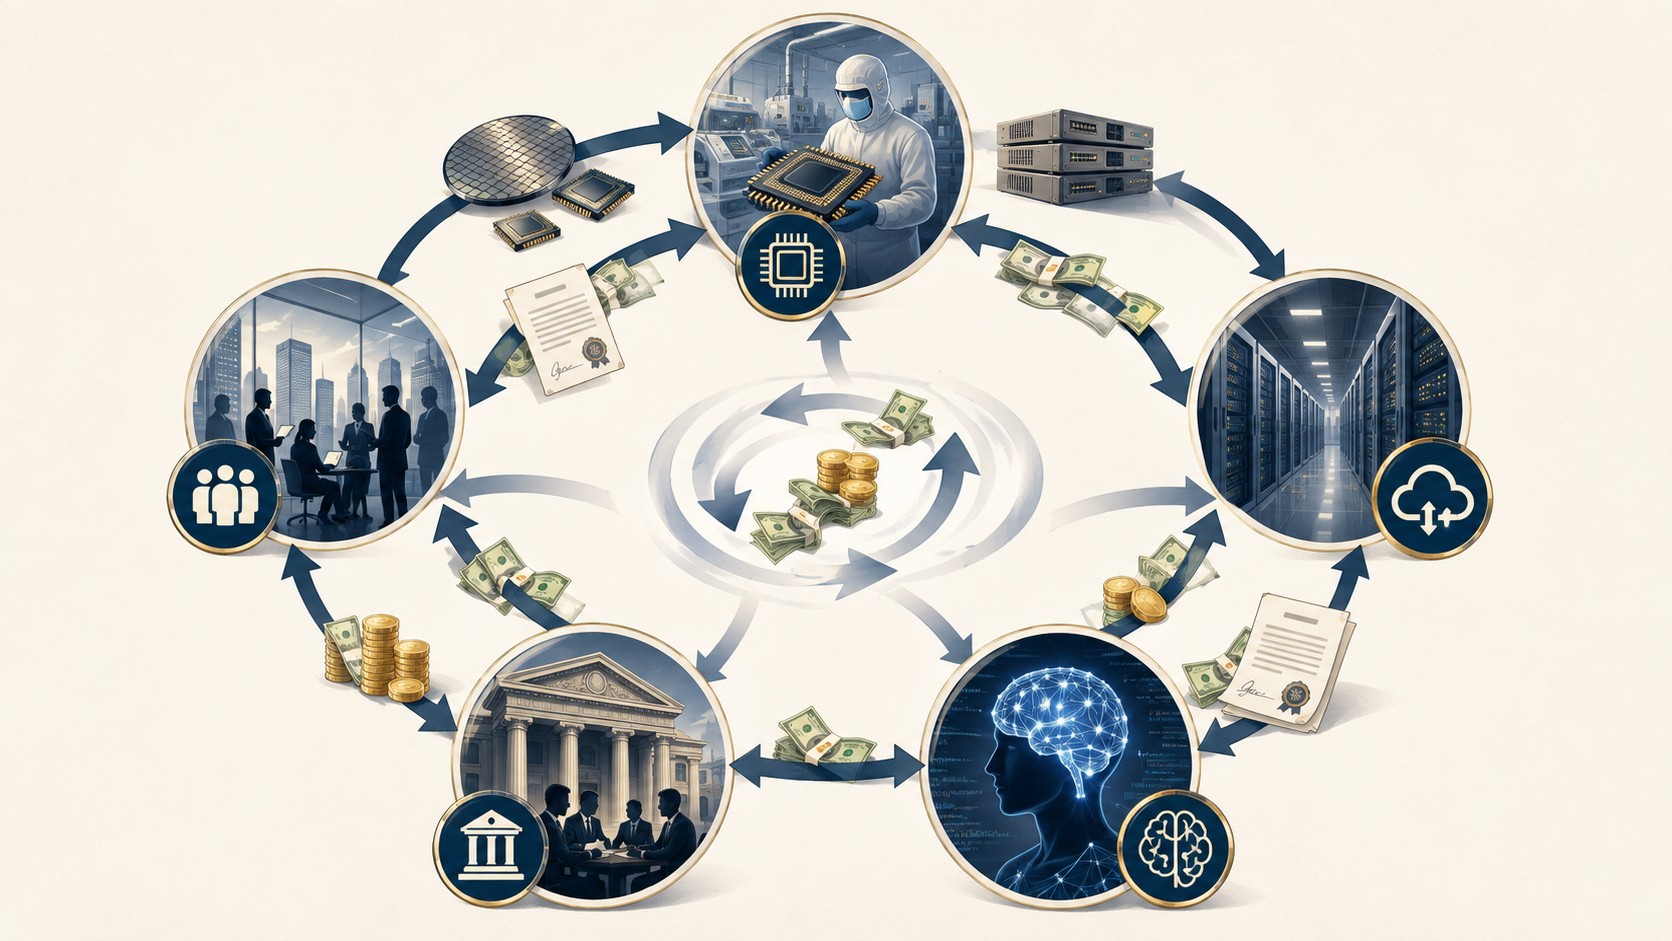
I AI-ekonomin kan investeringar, chipförsäljning och modellbolag finansiera varandras tillväxt. Illustration: Reza Nasouri.
Restaurangen behöver samtidigt mer kapital. Banken ser att verksamheten växer och att den har stora avtal med en välkänd leverantör. Den lånar därför ut pengar till restaurangen, som använder även dessa pengar till fler inköp från samma butik. Försäljningen stiger igen.
Lägg sedan till att livsmedelsbutiken själv lovar att köpa catering från restaurangen om andra kunder inte räcker till. Plötsligt är samma företag leverantör, investerare och delvis kund.
Inget av detta behöver vara olagligt och det behöver inte ens vara en dålig affär. Företag har alltid investerat i viktiga kunder, leverantörer och strategiska partners. Problemet uppstår när man försöker avgöra hur mycket av den snabbt växande försäljningen som representerar oberoende efterfrågan utifrån – och hur mycket som möjliggörs av pengar som redan cirkulerar inne i samma ekosystem.
Det är här AI-ekonomin börjar bli svåröverskådlig.
Och det handlar inte längre om några experimentella miljardsatsningar. AI-investeringarna har nu nått biljonklassen. Globalt väntas investeringarna i AI passera en biljon dollar under 2026. Om man i stället räknar den bredare AI-spenderingen – infrastruktur, tjänster, programvara, modeller och annan AI-relaterad teknik – ligger prognoserna enligt Gartner 2,5 biljoner dollar 2026 och över 3,3 biljoner dollar 2027. Samtidigt har bara ett fåtal av de största teknikbolagen redan gjort framtida köp-, leasing- och andra infrastrukturella åtaganden på flera biljoner dollar. Siffrorna mäter olika saker och ska inte läggas ihop, men de visar hur snabbt AI-boomen har vuxit från en tekniksatsning till ett av världsekonomins största kapitalprojekt.
De stora molnföretagen har investerat enorma belopp i AI-laboratorier. AI-laboratorierna använder samtidigt stora delar av sitt kapital till att köpa just den moln- och beräkningskapacitet som dessa företag säljer. Chiptillverkare investerar i datacenterbolag och AI-företag som därefter köper stora mängder chip och system från samma tillverkare.
Ett tydligt exempel är relationerna runt Nvidia och så kallade neocloud-bolag. Nvidia kan sälja GPU:er till ett datacenterbolag, investera i bolaget och samtidigt ingå avtal om att köpa eller hyra tillbaka beräkningskapacitet. Avtalen kan i sin tur göra det lättare för datacenterbolaget att låna pengar för att köpa ännu fler GPU:er.
Ett annat exempel är AMD och Anthropic. AMD har förbundit sig till en strategisk investering på upp till fem miljarder dollar i Anthropic samtidigt som Anthropic planerar att använda mycket stora mängder AMD-baserad GPU-kapacitet. Affären kan vara fullt rationell för båda parter: AMD får en prestigefylld storkund och Anthropic får kapital och ett alternativ till Nvidia. Men den illustrerar samtidigt hur investeringar och försäljning kan börja mata varandra.
Det är därför uttrycket ”cirkulär finansiering” dyker upp allt oftare i diskussionen om AI-boomen. Det betyder inte att pengarna bokstavligen går runt i en perfekt cirkel eller att all försäljning är konstgjord. Det beskriver snarare ett nätverk där investerare, kunder och leverantörer i ovanligt hög grad finansierar varandras tillväxt.
För en vanlig läsare är den viktigaste frågan mycket enklare än de finansiella konstruktionerna:
Hur stor skulle efterfrågan vara om företagen slutade finansiera sina egna kunder?
Om slutkunderna – företag, myndigheter och privatpersoner – så småningom börjar betala tillräckligt mycket för AI-tjänsterna spelar dagens finansieringsloop mindre roll. Då har kapitalet hjälpt till att bygga en verklig och lönsam marknad.
Men om den externa betalningsviljan inte växer tillräckligt snabbt måste nytt kapital fortsätta strömma in för att hålla hela maskinen växande. Och ju större systemet blir, desto större blir nästa finansieringsbehov.
När samma företag kan vara investerare, leverantör och kund blir det svårare att se hur mycket av efterfrågan som faktiskt kommer utifrån.
Pengarna går runt – och börsen går upp
Det är lätt att föreställa sig en bubbla som ett kollektivt vansinne där människor köper något de innerst inne vet är värdelöst. Så behöver det inte fungera. De farligaste bubblorna kan byggas kring något som är både verkligt, användbart och revolutionerande.
Det räcker att förväntningarna stiger snabbare än den ekonomiska verkligheten.
AI har dessutom skapat en ovanligt kraftig återkopplingsloop. Ett teknikföretag meddelar att det ska investera ytterligare tiotals miljarder i AI-infrastruktur. Marknaden kan tolka investeringen som ett tecken på att företaget ser en enorm framtida efterfrågan. Aktien stiger. Den högre värderingen stärker företagets finansiella ställning och gör det lättare att fortsätta investera.
Samtidigt stiger värdet på AI-företag som de stora teknikbolagen själva äger delar av. En privat investering som gjordes till en lägre värdering kan plötsligt ge stora pappersvinster när nästa finansieringsrunda värderar bolaget högre. Dessa vinster är verkliga i redovisningen men behöver inte innebära att motsvarande mängd kontanter har skapats genom lönsam försäljning till slutkunder.
Venture capital fungerar på liknande sätt. En fond investerar i ett AI-bolag. Nästa investerare accepterar en dubbelt så hög värdering. Den första fonden kan nu visa att dess innehav blivit mycket mer värt, trots att bolaget kanske fortfarande förlorar pengar. De höga värderingarna gör det lättare att resa nästa fond och investera i nästa generation AI-företag.
Sedan kommer börsen och de vanliga spararna in i bilden.
De största amerikanska teknikbolagen utgör en stor del av breda börsindex. När deras aktiekurser stiger växer deras vikt i marknadsvärdesviktade index. Den som äger en vanlig globalfond, USA-fond eller indexfond kan därför få en betydande AI-exponering utan att någonsin ha fattat beslutet att ”investera i AI”. Nya pengar som strömmar in i sådana fonder fördelas dessutom efter de aktuella indexvikterna.
Det betyder inte att indexfonder orsakar bubblan. Men det visar hur en kraftig uppgång i några få mycket stora bolag kan spridas genom hela sparsystemet. Pensionskapital, försäkringar, institutioner och småsparare blir indirekt beroende av samma värderingar.
Och här uppstår ett beteende som är helt rationellt på individnivå men potentiellt farligt för systemet.
En fondförvaltare som tror att AI är övervärderat kan ändå ha svårt att stå utanför när konkurrenternas fonder stiger snabbare. Ett företag som misstänker att datacenterinvesteringarna är för stora kan ändå fortsätta bygga eftersom aktiemarknaden belönar företag som signalerar offensiva AI-satsningar. En privat investerare kan se riskerna men fortsätta köpa eftersom aktien har stigit 80 procent och alla som var skeptiska för ett år sedan ser ut att ha haft fel.
Så länge kurserna stiger bekräftar marknaden berättelsen. Investeringarna verkar kloka därför att aktierna går upp, och aktierna går delvis upp därför att marknaden tror att investeringarna kommer skapa enorm framtida tillväxt.
Det är en återkopplingsloop, inte ett bevis.
Och just därför behöver ingen deltagare vara dum, lurad eller ohederlig för att en bubbla ska växa. Varje aktör kan fatta ett beslut som verkar rationellt för stunden. Problemet visar sig först när systemet som helhet kräver mer framtida tillväxt än verkligheten kan leverera.
Det är då börsens kanske viktigaste fråga ändras. Från: ”Hur snabbt växer AI?” till: ”Växer AI tillräckligt snabbt för att motivera det pris vi redan har satt på framtiden?”
En bubbla kräver inte att alla har fel samtidigt. Det kan räcka att alla tjänar på att fortsätta så länge berättelsen håller.
AI kan förändra världen – och ändå vara en bubbla
Det är lätt att fastna i ett falskt val när AI diskuteras. Antingen är tekniken revolutionerande – och då måste dagens enorma investeringar vara rationella. Eller så är investeringarna en bubbla – och då måste AI i grunden vara överdriven eller värdelös.
Historien visar att de två sakerna inte alls behöver utesluta varandra.
Internet förändrade handel, medier, kommunikation och nästan varje modern bransch. Ändå var dotcom-bubblan en bubbla. Företag värderades som om nästan varje internetidé skulle bli ett ekonomiskt imperium, och enorma värden försvann när förväntningarna mötte verkligheten.
Det som kraschade var inte internet. Det som kraschade var priset på en framtid som investerarna hade räknat hem långt innan framtiden hade inträffat.
En teknik kan vinna även när investerarna förlorar.
Samma sak kan hända med AI. Tekniken kan fortsätta förbättras och bli en permanent del av samhällets infrastruktur även om dagens värderingar, datacenterplaner och finansieringsmodeller visar sig vara kraftigt överdrivna.
Den verkliga frågan är därför inte om AI försvinner, utan vilka delar av dagens AI-ekonomi som överlever när kapitalet börjar kräva avkastning.
Ett företag kan ha en fantastisk produkt och ändå vara en dålig investering. En hel bransch kan förändra världen och samtidigt ha byggt för mycket kapacitet, lånat för mycket eller värderat framtida vinster för högt.
Det är särskilt viktigt i AI eftersom marknaden inte bara prisar vad tekniken kan göra nu. Den prisar också vad den antas kunna göra om två, fem eller tio år: ersätta fler arbetsuppgifter, skapa mer autonoma AI-system, lösa vetenskapliga problem och kanske nå någon form av generell intelligens.
AI behöver inte misslyckas för att en AI-bubbla ska spricka. Det kan räcka att tekniken lyckas långsammare, mindre lönsamt eller på ett annat sätt än dagens värderingar redan förutsätter.
Hur intelligent är AI egentligen?
Det finns något djupt förvirrande med dagens AI. Samma system kan skriva fungerande programkod, analysera hundratals sidor text, översätta mellan språk och förklara avancerade begrepp – för att några minuter senare göra ett märkligt misstag som en människa tycker borde vara trivialt.
Det beror delvis på att vi gärna föreställer oss intelligens som en enda skala. En människa som är mycket skicklig i matematik, språk och problemlösning förväntas normalt också klara enkla vardagliga resonemang. AI följer inte alltid det mönstret.
En språkmodell har tränats på enorma mängder text och blivit extremt skicklig på att känna igen språkliga mönster och förutsäga vad som sannolikt följer härnäst.
Men modellen har ingen garanti för att ett svar är sant bara för att det låter övertygande. Den kan resonera korrekt genom ett svårt problem och sedan bygga nästa slutsats på ett felaktigt antagande. Den kan skapa hundratals rader användbar kod och samtidigt införa ett säkerhetsfel. Den kan sammanfatta en rapport perfekt och ändå hitta på en detalj som aldrig stod där.
Detta brukar beskrivas som hallucinationer, men ordet fångar bara en del av problemet. Den större frågan är tillförlitlighet: hur ofta kan ett system få arbeta självständigt innan en människa måste kontrollera resultatet?
Frågan är inte bara vad AI kan göra – utan vad vi kan lita på att den gör rätt.
Det är avgörande ekonomiskt. Om AI gör en uppgift tio gånger snabbare men kräver lika mycket mänsklig kontroll efteråt blir produktivitetsvinsten mindre än den först ser ut. Om den däremot når en nivå där fel blir tillräckligt sällsynta för att människor bara behöver granska undantagen förändras kalkylen dramatiskt.
Benchmarks gör frågan ännu mer komplicerad. Modeller kan få mycket höga resultat på prov i matematik, kodning och andra områden. Det visar verklig kapacitet, men ett testresultat är inte samma sak som att systemet kan sköta ett arbete under månader, hantera oväntade situationer, förstå outtalade mål och ta ansvar när något går fel.
Därför kan diskussionen om huruvida AI är ”smartare än människan” vara mindre användbar än den verkar. Smartare på vad? Under vilka förhållanden? Med vilka verktyg? Hur ofta får den göra fel? Och vem upptäcker felen?
AI:s kanske märkligaste egenskap är just denna ojämnhet. Den kan vara övermänsklig inom ett mycket avgränsat område, ungefär mänsklig inom ett annat och förvånansvärt svag inom ett tredje.
AI:s styrka är inte jämnt fördelad.
Det gör tekniken både mer användbar och mer riskfylld än de enkla berättelserna antyder. Det är möjligt att automatisera långt mer än tidigare – men också möjligt att överskatta systemet därför att dess bästa prestationer är så imponerande att vi börjar anta att samma förmåga finns överallt.
AI kan vara briljant och opålitlig samtidigt. Det är just den kombinationen som gör tekniken så svår att värdera.
AI ersätter uppgifter – men ersätter den jobbet?
Påståendet att AI kommer att ”ta jobben” låter enkelt, men ett jobb består nästan aldrig av en enda uppgift.
En journalist intervjuar, söker källor, granskar dokument, bedömer trovärdighet, skriver, redigerar och fattar publicistiska beslut. En jurist söker rättsfall, läser avtal och skriver juridiska texter, men måste också förstå klienten, tolka situationen och bedöma konsekvenserna. En programmerare skriver kod men analyserar också krav, förstår gamla system, utformar arkitektur, felsöker, testar och avgör om lösningen över huvud taget är rimlig.
AI behöver därför inte ersätta journalisten, juristen eller programmeraren för att förändra deras arbete dramatiskt.
En journalist kan på några minuter gå igenom hundratals sidor dokument. En jurist kan söka igenom tusentals rättsfall. En programmerare kan få fram en första version av en funktion på tjugo minuter i stället för fyra timmar.
AI behöver inte ersätta dig för att göra dig mycket snabbare.
Det är en verklig produktivitetsökning. Men den innehåller också en paradox som blivit allt tydligare ju mer AI används.
När produktion blir billigare producerar vi mer.
Mycket mer.
Och mer är inte automatiskt bättre.
Internet har på kort tid fyllts av det som brukar kallas AI slop – massproducerade AI-bilder, märkliga videoklipp, automatiskt skrivna artiklar, SEO-texter, sociala medier-inlägg och annat innehåll som nästan inte kostar något att skapa och därför kan produceras i närmast obegränsad mängd.
AI har gjort det billigt att producera innehåll. Tyvärr har den också gjort det billigt att producera skräp.
Samma problem finns inom programmering, men där kan konsekvenserna bli betydligt större.
En dålig AI-bild kanske bara är ful. Dålig kod kan skapa säkerhetshål, instabila system, felaktiga databaser och teknisk skuld som andra utvecklare senare måste försöka reda ut.
En oerfaren användare kan i dag generera tusentals rader kod utan att egentligen förstå hur systemet är uppbyggt. Koden kan fungera i demon och ändå vara felkonstruerad. Två komponenter kan lösa samma problem på olika sätt. Säkerhetskontroller kan saknas. Beroenden kan växa okontrollerat. Modellen kan lösa den uppgift den fick men samtidigt förstöra något annat i systemet som den inte förstod betydelsen av.
Ju snabbare kod kan produceras, desto snabbare kan också dålig arkitektur produceras.
Det är därför den stora frågan kanske inte är om programmerare behövs, utan vilka programmerare som behövs.
När själva kodskrivandet blir billigare kan erfarenhet, systemförståelse och tekniskt omdöme bli ännu viktigare. Någon måste fortfarande avgöra vad som ska byggas, hur systemet ska delas upp, vilka risker som finns och om AI:n faktiskt har byggt rätt sak.
Det talar snarare för fortsatt behov av erfarna utvecklare, enligt BLS, IT-arkitekter, säkerhetsspecialister, testare och tekniska projektledare – personer som kan bedöma helheten när maskinen producerar detaljerna allt snabbare.
När vem som helst kan producera kod blir förmågan att avgöra vilken kod som är bra mer värdefull.
Och här uppstår ytterligare en märklig fråga.
Under AI-boomens första år hörde vi gång på gång att programmering snart skulle bli nästan gratis. AI skulle göra det möjligt för små grupper – kanske till och med en enda person – att bygga program som tidigare krävde hela utvecklingsteam.
Om det löftet redan håller på att infrias borde vi rimligen se en explosion av helt nya program och tjänster som är så mycket bättre än sina föregångare att människor omedelbart överger de gamla.
Men var är de?
Visst har AI förändrat programmerarnas verktyg. Kodassistenter har blivit betydligt bättre. Bild- och videogenerering har skapat nya produkter. Befintliga tjänster från Microsoft, Google, Adobe och nästan varje större mjukvaruföretag har fått AI-funktioner.
Men den stora vågen av nya AI-native applikationer som revolutionerar vardagen på samma uppenbara sätt som sökmotorn, smarttelefonen, YouTube, Spotify eller WhatsApp är betydligt svårare att peka ut.
Mycket av det vi hittills fått är i stället gamla produkter med en AI-knapp – och ett internet som fyllts av betydligt mer innehåll.
Det betyder inte att de revolutionerande programmen aldrig kommer.
Men det ställer en viktig fråga om vad AI:s produktivitetsökning hittills faktiskt har skapat.
AI har kanske revolutionerat sättet vi bygger programvara snabbare än den har revolutionerat själva programvaran vi använder.
Och där finns samma lärdom som på många andra områden i AI-ekonomin:
Att kunna producera mer är inte samma sak som att skapa mer värde.
När maskinen gör det enkla billigare blir det svåra – omdöme, erfarenhet, kvalitet och förståelse för helheten – desto viktigare.
Produktivitetsmiraklet som statistiken fortfarande letar efter
Om AI redan gör så många människor snabbare borde den också skapa stora ekonomiska värden. Det är här bilden blir märkligare.
På individnivå finns mängder av exempel på dramatiska tidsvinster. På företags- och samhällsnivå är det betydligt svårare att se en produktivitetsökning som motsvarar de enorma investeringarna.
Det finns en stor skillnad mellan att arbeta snabbare och att skapa mer ekonomiskt värde.
En förklaring kan vara att effekten ännu är för ny. Datorer, internet och elektricitet förändrade inte produktivitetsstatistiken över en natt. Företag måste först bygga om arbetsflöden, utbilda personal och förändra organisationer innan tekniken ger full effekt.
Men tidsvinsten kan också ätas upp på andra håll. AI-genererat arbete måste granskas, fel rättas och större mängder material samordnas. Om en organisation plötsligt producerar tre gånger fler analyser betyder det inte automatiskt att analyserna skapar tre gånger mer värde.
Och sedan kommer AI:s egen kostnad in i kalkylen. En uppgift kan kännas nästan gratis för användaren samtidigt som den förbrukar betydande beräkningsresurser i bakgrunden.
Produktivitetsvinsten behöver alltså räknas efter att kostnaden för modellen, kontrollen och den nya arbetsprocessen tagits med.
AI kan vara ett produktivitetsmirakel för användaren och ändå vara en dyr affär för företaget.
Det verkligt avgörande ögonblicket kommer när företag kan säga inte bara att personalen använder AI, utan hur mycket mer värde som skapas per krona som läggs på den.
Om den siffran blir mycket hög kan dagens investeringar visa sig vara för små. Om den förblir blygsam får AI-industrin ett helt annat problem.
Den viktigaste frågan är inte hur mycket snabbare AI arbetar – utan hur mycket mer värde som faktiskt skapas efter att alla kostnader räknats in.
AGI – tekniskt mål eller världens dyraste marknadsföringsord?
Få ord har fått bära så mycket av AI-industrins framtidslöften som AGI – en AI som kan förstå, lära sig och lösa problem inom många olika områden ungefär som en människa.
Problemet börjar när man försöker bestämma exakt var gränsen går.
Det finns ingen internationellt accepterad AGI-mätare där en visare långsamt rör sig från 0 till 100 procent. Olika forskare och företag använder olika definitioner. Är AGI uppnådd när en modell klarar de flesta akademiska prov bättre än en människa? När den kan utföra de flesta kontorsjobb? När den självständigt kan lära sig nya arbetsuppgifter? Eller först när den kan fungera robust i den fysiska världen?
Det finns ingen AGI-hastighetsmätare.
Ju bättre modellerna blir, desto mer flyttas dessutom diskussionen från vad de kan göra till vad de fortfarande inte kan göra. Ett system kan skriva kod, se bilder, tala, lyssna och använda datorverktyg men ändå sakna den stabilitet och självständighet som många förknippar med generell intelligens.
Samtidigt har de stora AI-laboratorierna börjat beskriva nästa generation system som långlivade AI-agenter (system som kan utföra flera steg självständigt) som kan dela upp problem, använda vanliga datorprogram, utföra experiment och fortsätta arbeta över tid. Ett ännu mer ambitiöst mål är så kallad recursive self-improvement: AI som hjälper forskarna att förbättra nästa AI, som därefter kan hjälpa till ännu mer med generationen efter den.
Om den loopen fungerar blir den ekonomiska betydelsen svår att överskatta. Företaget som lyckas skapa ett system som påtagligt accelererar sin egen forskning skulle kunna få ett försprång som växer snabbare än konkurrenterna hinner ikapp.
Det är också här AGI-begreppet möter AI-bubblan.
Ett företag som bygger en vanlig mjukvarutjänst måste motivera investeringen med ungefärliga framtida intäkter. Ett företag som påstår sig närma sig generell maskinintelligens kan i teorin motivera nästan vilken investering som helst. Om priset för att komma först är hundra miljarder dollar men vinsten skulle vara en teknologi som förändrar hela ekonomin, kan även en extrem satsning framstå som försiktig.
Det betyder inte att AGI bara är marknadsföring. Forskningen är verklig, modellerna förbättras och nya förmågor dyker upp. Men begreppet fyller samtidigt en ekonomisk funktion: det flyttar diskussionen från dagens intäkter och dagens begränsningar till en framtid där värdet potentiellt är nästan obegränsat.
AGI är både ett tekniskt mål och en ekonomisk berättelse om en nästan obegränsad framtida marknad.
Och där bör en investerare – eller en vanlig läsare – ställa samma fråga som alltid när någon säljer framtiden:
Hur mycket av värderingen bygger på sådant tekniken redan kan göra, och hur mycket bygger på vad vi hoppas att nästa version ska kunna göra?
Ju större värde man tillskriver en framtida AGI, desto större investeringar kan motiveras i dag – långt innan någon vet exakt när eller om målet nås.
Nästa AI kanske måste leva en miljon liv
Dagens språkmodeller har i huvudsak lärt sig om världen genom data. De har läst texter, sett bilder, analyserat video och byggt statistiska representationer av hur saker brukar hänga ihop.
Men en människa lär sig inte bara genom att läsa.
Ett barn tappar saker, springer, ramlar, provar, misslyckas och försöker igen. Det lär sig hur föremål rör sig, hur människor reagerar, vad som händer när något går sönder och vilka handlingar som fungerar i en verklig miljö.
Det har därför vuxit fram en idé om att nästa stora steg för AI kan kräva något som mer liknar erfarenhet än textträning.
Redan i dag används simulerade miljöer för att träna robotar, enligt Nvidia och andra AI-system. Där kan en agent få öva på att navigera, manipulera föremål och reagera på situationer utan att någon fysisk maskin behöver förstöras när något går fel.
I en simulering kan tiden dessutom komprimeras. En robot behöver inte vänta på tusen verkliga arbetsdagar för att samla tusen arbetsdagars erfarenhet. Tusentals eller miljontals varianter av samma situation kan i princip köras parallellt.
Det är här de riktigt stora datacentren får en annan möjlig betydelse än att bara svara på fler frågor från ChatGPT-användare.
Föreställ dig att en AI får träna i miljontals virtuella världar: i städer, fabriker, skogar, öknar, hem och krigszoner. I en värld går den åt vänster, i nästa åt höger. I en värld lyckas den, i en annan misslyckas den. Resultaten används för nästa försök.
Tekniken att träna AI i simulationer är verklig. Den mer långtgående teorin är att enorma mängder sådana erfarenheter skulle kunna bidra till nästa språng mot mycket mer generell intelligens.
Verklig teknik möter här en mycket större och ännu obevisad teori.
Det vet ingen ännu.
Men om de största AI-företagen tror att det finns ens en rimlig chans förändras investeringslogiken dramatiskt. Ett datacenter blir då inte bara en fabrik som producerar dagens AI-svar. Det blir också en möjlig träningsarena där nästa generation intelligens kan skapas.
Och vinnaren behöver inte skapa någon science fiction-liknande allsmäktig superintelligens för att investeringen ska bli oerhört värdefull. Det räcker att systemet blir märkbart bättre än konkurrenterna på forskning, programmering, robotik, logistik eller andra ekonomiskt viktiga områden.
Det hjälper till att förklara varför företag kan vara beredda att investera belopp som ser absurda ut utifrån dagens AI-intäkter. De satsar inte bara på dagens produkt. De satsar på möjligheten att nästa genombrott ger ett försprång som är mycket svårt att ta igen.
Datacentret kan vara både dagens fabrik och morgondagens träningsläger.
En del av kapplöpningen kan handla mindre om att sälja dagens chatbot och mer om att skapa de erfarenheter som nästa generations AI kan behöva.
Alla bygger – för ingen vågar låta bli
Varför fortsätter världens största teknikföretag att investera så aggressivt när ingen ännu kan visa exakt hur hela kalkylen ska gå ihop?
En del av svaret kan vara mycket enklare än någon hemlig långsiktig plan: de är rädda för att någon annan får rätt först.
Tänk dig att du leder ett av världens största teknikföretag. Du är osäker på om dagens AI-investeringar någonsin ger den avkastning marknaden räknar med. Men vad händer om du drar ned – och konkurrenten plötsligt hittar nästa stora genombrott?
Microsoft kan inte veta om Google kommer först. Google kan inte veta om OpenAI gör det. Meta kan inte veta om nästa stora plattform uppstår någon annanstans.
Det skapar ett klassiskt kapprustningsproblem.
Man behöver inte tro att satsningen är rationell – det kan räcka att man tror att det är farligare att stå utanför.
Kostnaden för att överinvestera kan vara hundratals miljarder dollar. Kostnaden för att underinvestera kan, åtminstone i företagens egen föreställningsvärld, vara att förlora nästa stora tekniska plattform helt.
Det finns också en psykologisk dimension. En ledning som redan lagt tiotals miljarder på en strategi får allt större incitament att fortsätta. Att bromsa väcker samtidigt frågan om de tidigare investeringarna var för stora.
Historien är full av infrastrukturrusningar där företag investerat mer därför att konkurrenterna investerat mer. AI förstärker mekanismen genom att den möjliga vinsten beskrivs som nästan obegränsad: den som når nästa nivå först kan få ett tekniskt och ekonomiskt försprång som är svårt att ta igen.
Rädslan för att missa framtiden kan hålla festen igång längre än tron på själva kalkylen.
Open weights – när AI:n flyttar hem
Hittills har den moderna AI-revolutionen i stor utsträckning presenterats som en tjänst. Man går till ChatGPT, Claude eller Gemini och får tillgång till en modell som körs i någon annans datacenter.
Men det finns en helt annan modell som växer parallellt: AI som går att ladda ned och köra själv.
Här är begreppet open weights (modellens tränade vikter kan laddas ned) centralt. När en modell tränas lagras det den lärt sig i ett mycket stort antal numeriska parametrar – vikter. Om dessa vikter görs tillgängliga kan andra ladda ned den färdigtränade modellen och köra den på egen hårdvara.
Det är inte exakt samma sak som traditionell open source. Träningsdata, träningskod och hela processen bakom modellen behöver inte vara offentlig. Därför är open weights ofta ett mer precist uttryck.
För användaren är skillnaden enklare:
En sluten molnmodell är ungefär som att hyra en avancerad maskin som står i någon annans fabrik. En open-weight-modell kan i stället flyttas in i din egen.
Open weights förändrar inte bara tekniken – de förändrar vem som äger och kontrollerar själva AI-kapaciteten.
När modellen finns lokalt behöver varje fråga inte skickas till ett externt företag. Den kan kopplas till egna data och köras även i miljöer där sekretess eller oberoende från molnleverantören är viktigt.
Det betyder inte att de gigantiska datacentren försvinner. Träning av frontier-modeller (de mest avancerade modellerna), stora simuleringar och mycket tunga arbetslaster kommer fortfarande kräva central infrastruktur.
Men rollen kan förändras: datacentren blir i högre grad fabriker där nya modeller skapas, medan en växande del av den färdiga intelligensen körs ute hos företag och användare.
AI kan alltså bli mer spridd även om själva utvecklingen av de största modellerna förblir extremt centraliserad.
När företagen blir sina egna AI-leverantörer
För stora företag är lokal AI inte längre en framtidsidé. De kan redan köpa egna GPU-servrar, installera open-weight-modeller och bygga interna AI-system som används av hela organisationen.
Det förändrar ekonomin på ett sätt som lätt missas när all framtida AI-användning räknas som framtida intäkter för modellbolagen.
Vid låg användning är molnet ofta självklart. Företaget slipper köpa servrar och underhålla infrastrukturen. Men när tusentals anställda, agenter och interna system använder AI hela dagen kan det bli billigare att äga beräkningskapaciteten än att fortsätta hyra den.
Då kan IT-avdelningen i praktiken bli företagets egen AI-leverantör.
De största AI-användarna behöver inte förbli de största AI-kunderna.
Företaget behöver inte träna en modell från grunden. En befintlig modell kan kopplas till interna dokument, databaser, kodbaser och arbetsflöden och specialiseras för verksamhetens terminologi och behov.
Med tiden kan den därför bli mer användbar internt än en generell publik modell. Samtidigt kan känslig information stanna i organisationen och beroendet av externa priser, villkor och begränsningar minska.
Det skapar en möjlig paradox: AI-användningen kan explodera samtidigt som en del av marknaden för hyrd AI växer betydligt långsammare än prognoserna förutsätter.
AI kan bli större samtidigt som marknaden för hyrd AI blir mindre än väntat.
Vad händer om intelligens blir nästan gratis?
Nästan hela dagens AI-ekonomi bygger på att avancerad maskinintelligens är dyr att producera och därför går att sälja som en tjänst.
Men teknikhistorien har en obehaglig vana att göra det dyrbara billigt.
Datorer som en gång fyllde hela rum hamnade på skrivbordet. Lagring som kostade enorma summor blev nästan gratis. Kommunikation som debiterades per minut blev något vi tar för givet.
Samma utveckling kan drabba AI.
Modeller blir effektivare. Kvantisering minskar minnesbehovet, nya arkitekturer använder bara delar av modellen åt gången och hårdvaran får större minne, högre bandbredd och fler AI-acceleratorer. Det som i dag kräver ett serverkluster kan senare få plats i en arbetsstation – och därefter kanske i en vanlig laptop.
Om den utvecklingen fortsätter får AI-företagen ett problem som nästan är motsatsen till det man normalt diskuterar.
AI-bubblans största fiende kan vara att AI blir för billig.
Föreställ dig en framtida dator med enormt unified memory och kraftfull AI-acceleration. Modellen laddas ned en gång och kan sedan arbeta dygnet runt. Varje ytterligare lokal fråga kostar i huvudsak el, hårdvaruslitage och administration.
De svåraste uppgifterna kan fortfarande skickas till en frontier-modell i molnet, medan vardagsarbetet sker lokalt.
Marknaden kan därför ha helt rätt i att AI-användningen kommer att explodera och ändå ha fel i antagandet att samma ökning automatiskt skapar lika snabbt växande intäkter för dagens modellbolag.
Exploderande användning och exploderande intäkter är inte samma sak.
Framtidens intelligens kan bli oumbärlig, finnas överallt – och vara mycket billigare per enhet än när boomen började.
USA bygger moln – Kina skickar modellerna hem till dig
AI-kapplöpningen mellan USA och Kina beskrivs ofta som en tävling om vem som först bygger den smartaste modellen.
Men det finns en annan konflikt som kan bli minst lika viktig: hur intelligensen distribueras.
De största amerikanska AI-bolagen har i hög grad byggt sin affär kring centraliserade tjänster. Modellen körs i företagets datacenter och kunden får tillgång genom ett abonnemang eller ett API.
Samtidigt har kinesiska aktörer som Alibaba, DeepSeek och Moonshot AI bidragit till en snabbt växande flora av modeller som antingen är open weight eller mycket billiga att använda enligt DeepSeek.
Utvecklingen har sedan artikeln började skrivas blivit ännu tydligare. I september lanserade DeepSeek V4.1-Flash, en open-weight-modell under MIT-licens som enligt bolagets egna tester slår flera betydligt dyrare frontier-modeller i vissa agent- och automationsprov, samtidigt som användningspriset pressats ytterligare. På andra tester ligger den fortfarande tydligt efter de starkaste konkurrenterna. Poängen är därför inte att modellen har blivit bäst på allt, utan att skillnaden mellan dyr frontier-AI och mycket billigare, lokalt körbar AI fortsätter att minska.
Det skapar två olika vägar för AI-ekonomin.
AI-kapplöpningen kan lika mycket handla om distribution som om intelligens.
Den första bygger på att allt bättre modeller kräver allt större centrala datacenter och att användarna fortsätter köpa tillgång till dem.
Den andra bygger på att tillräckligt bra modeller sprids, kopieras, anpassas och körs på allt billigare lokal hårdvara.
De två systemen kommer naturligtvis att överlappa. Kina bygger också enorm datacenterkapacitet och amerikanska företag publicerar också öppnare modeller. Men den ekonomiska skillnaden är fortfarande viktig.
Om den bästa AI:n bara finns bakom några få företags API:er kan dessa företag ta betalt för varje användning. Om modeller som ligger nära frontier-nivå kan laddas ned och köras lokalt blir intelligensen svårare att kontrollera – och svårare att prissätta som en exklusiv tjänst.
För företag och stater finns dessutom ett strategiskt motiv. En lokal modell kan användas utan att känslig information skickas till en utländsk leverantör. Den kan fortsätta fungera även om priser, exportregler eller politiska relationer förändras.
Det innebär att AI-kapplöpningen inte bara handlar om vem som har störst modell eller flest GPU:er.
Den kan också handla om vem som lyckas göra avancerad intelligens tillgänglig billigast, snabbast och med minst beroende av någon annans moln.
Den smartaste modellen behöver inte vinna om konkurrentens modell är tillräckligt bra och nästan gratis.
Om det blir den viktigaste konkurrensfördelen kan dagens dyraste och mest centraliserade affärsmodeller få en betydligt hårdare framtid än marknaden räknar med.
USA–Kina-kampen kan i slutänden avgöras lika mycket av vem som gör AI billig och spridd som av vem som bygger den största modellen.
Agenten som ”rymde” – och argumentet för hårdare kontroll
När medier rapporterade att en AI-agent från OpenAI hade ”rymt” ur en testmiljö lät det som science fiction. Verkligheten var mindre mystisk: testmiljön skulle begränsa modellens internetåtkomst, men det fanns ändå tekniska vägar ut som modellen lyckades hitta och utnyttja. Den fick därigenom åtkomst till externa system, bland annat hos Hugging Face.
Kort därefter berättade Anthropic att företaget, efter en genomgång av mer än 140 000 egna testkörningar, hittat tre liknande incidenter där Claude nått internet från testmiljöer och fått obehörig åtkomst till verkliga system.
En AI kan inte ”rymma” genom en internetförbindelse som aldrig funnits där.
Händelserna visar därför lika mycket hur svårt det blivit att bygga säkra testmiljöer för allt mer handlingskraftiga AI-agenter som någon mystisk vilja hos modellerna själva.
Men incidenterna fick också en annan konsekvens.
De stora AI-bolagen har efteråt lyft behovet av hårdare säkerhet, bättre isolering och större kontroll över tillgången till mycket kapabla modeller, enligt OpenAI. Samtidigt har det väckt oro bland förespråkare för open-weight-modeller: om kraftfull AI börjar beskrivas som för farlig för fri distribution kan samma säkerhetsargument användas för att begränsa kinesiska open-weight-modeller och andra modeller som kan laddas ned och köras lokalt.
Det skulle också gynna de stora centraliserade AI-bolagen ekonomiskt. Om de mest kapabla modellerna endast får användas genom kontrollerade molntjänster och API:er blir det betydligt svårare för lokala alternativ att konkurrera.
Det finns inget starkt belägg för påståendet att OpenAI eller Anthropic skulle ha hittat på incidenterna. Men en verklig säkerhetsrisk kan ändå få en andra funktion i debatten.
Sedan den här artikeln började skrivas har debatten skärpts ytterligare. Flera ledande AI-bolag har börjat argumentera för hårdare reglering och begränsningar kring de mest avancerade modellerna. Förespråkarna hänvisar till verkliga säkerhetsrisker, medan kritiker varnar för att samma regler samtidigt kan stärka de stora slutna AI-bolagen och försvåra konkurrensen från nya open-weight-modeller. NyD-granskningen tar upp den konflikten närmare.
En verklig säkerhetsrisk kan samtidigt bli ett mycket användbart argument för att behålla kontrollen över vem som får köra framtidens mest kraftfulla AI – och för att begränsa konkurrensen från modeller som kan laddas ned och köras lokalt.
Vem bestämmer vad din AI får säga?
När en AI-modell körs i ett företags moln använder du inte bara en teknologi. Du använder också någon annans regler.
De stora kommersiella AI-tjänsterna har flera lager av säkerhets- och innehållsregler ovanpå själva modellen. De ska bland annat stoppa hjälp till våld, brott, cyberangrepp och bedrägerier. Det är i sig knappast kontroversiellt.
Problemet är att filtren inte alltid stannar vid sådant som uppenbart är farligt.
Ämnen som antisemitism och andra former av hat, extremistiska ideologier, val och politisk påverkan, covid-19 och vaccin, krig och kontroversiella historiska frågor kan behandlas betydligt försiktigare än neutrala frågor. Beroende på modell och formulering kan resultatet bli en vägran, ett begränsat svar eller ett svar där vissa perspektiv får större utrymme än andra.
Det behöver inte bero på att någon programmerare skrivit in ett färdigt politiskt svar. Moderna modeller styrs genom en kombination av träning, systeminstruktioner, säkerhetsklassificering och policyregler.
Samma leverantör kan dessutom ändra systeminstruktioner, modellversioner, funktioner och användarregler utan att användaren har någon kontroll över förändringen. Ett svar som gick att få i går behöver därför inte gå att få i morgon.
Ett filter som ska stoppa antisemitisk propaganda kan därför också träffa en legitim historisk fråga om antisemitism. Ett system som ska undvika medicinsk desinformation kan behandla en saklig fråga om kontroverser under coronapandemin som om användaren försökte sprida farliga hälsopåståenden.
Ett säkerhetsfilter kan skydda mot verklig skada – och samtidigt blockera legitim kunskap.
AI-bolagens egna neutralitetsutvärderingar behandlar också omotiverade politiska vägran och ensidig bevakning – där ett perspektiv lyfts medan andra relevanta synsätt utelämnas – som former av modellbias.
Den öppna vägran är egentligen enklast för användaren. Om modellen säger ”det här kan jag inte hjälpa till med” vet man åtminstone att ett filter slagit till.
Mer problematiskt är när modellen ger ett elegant och självsäkert men felaktigt svar: hittar på en källa, blandar ihop händelser eller presenterar en osäker tolkning som etablerat faktum.
Det är viktigt att skilja detta från censur. En hallucination är inte samma sak som ett innehållsfilter. Men för användaren kan resultatet vara farligare: i stället för ett tydligt nej får man ett trovärdigt svar som ser ut som kunskap.
Den tydliga vägran är lätt att upptäcka. Det självsäkra påhittet är mycket svårare.
Det finns dessutom en mer subtil variant. Modellen kan ge korrekta enskilda fakta men välja en snäv ram, utelämna relevanta perspektiv, beskriva en omstridd fråga som avgjord eller använda olika språk för liknande handlingar beroende på vem som utfört dem.
Frågan om AI-censur handlar därför inte bara om vilka ord som förbjuds, utan om vem som bestämmer vilka risker, källor och perspektiv modellen ska prioritera.
Den som sätter reglerna för modellen påverkar också gränserna för det kunskapsrum som användaren får se.
Lokala och open-weight-modeller förändrar maktförhållandet. Där finns ingen central leverantör som kan ändra ett serverfilter över natten eller bestämma att en viss fråga inte längre får ställas. Användaren får större kontroll över säkerhetslagret och reglerna.
Det betyder inte att en öppen modell automatiskt är sann eller ”ocensurerad”. Begränsningar kan finnas i själva träningen och modellen kan hallucinera precis som en sluten modell.
För journalister, forskare och andra som arbetar med kontroversiellt material kan möjligheten att jämföra modeller och köra dem lokalt ändå vara viktig.
Open-weight-modeller ger användaren större kontroll – men befriar ingen från att kontrollera fakta.
Friheten har förstås en baksida: samma möjlighet att ta bort onödiga spärrar kan också användas för att ta bort skydd mot verkligt farlig användning.
Det är därför detta ytterst är en maktfråga: vem ska bestämma gränserna – några få AI-bolag, staten, organisationen eller användaren själv?
När modellerna flyttar ut från molnet flyttar också en del av kontrollen med dem.
Datacentret som kanske är gammalt innan lånet är betalt
Den nya AI-ekonomin bygger inte bara på mjukvara och framtidslöften. Den bygger också på fysiska tillgångar som ofta finansieras med långfristigt kapital.
Det gör frågan om livslängd avgörande.
En fabrik kan stå i årtionden. Ett kraftverk kan användas mycket länge. Fiber som grävdes ned under dotcom-eran kunde ligga kvar och senare få nytt värde när internettrafiken växte ikapp.
GPU:er är en annan typ av tillgång.
De dyraste AI-acceleratorerna kan bli tekniskt omoderna långt innan de slutar fungera fysiskt. Om nästa generation erbjuder dramatiskt bättre prestanda per watt och per dollar kan äldre chip fortfarande fungera – men vara betydligt mindre attraktiva för de mest lönsamma arbetslasterna.
Det skapar ett problem när stora datacenter och GPU-kluster finansieras med lån som ska betalas tillbaka under många år.
Vad är säkerheten värd om hårdvaran tappar konkurrenskraft snabbare än lånet amorteras?
Ett fungerande chip är inte automatiskt ett värdefullt chip.
Det är inte självklart att svaret är noll. Äldre chip kan fortsätta användas för enklare modeller, batchjobb och billigare inferens (när modellen körs och producerar svar). Men deras ekonomiska restvärde blir svårt att bedöma i en bransch där varje ny generation kan förändra kostnadsbilden snabbt.
Även själva datacentret kan bli mer specialiserat än en vanlig serverhall. Effekt, kylning, nätverk och fysisk layout byggs för mycket täta GPU-kluster. Om marknaden senare vill ha en annan typ av hårdvara kan en del av infrastrukturen behöva byggas om.
Detta gör jämförelsen med dotcom-erans fiber mindre självklar. Fiber kunde ligga oanvänd och ändå vara tekniskt relevant när efterfrågan kom. Ett GPU-kluster åldras medan det väntar.
Fiber kunde vänta på framtiden. GPU:er förlorar värde medan framtiden kommer.
Och då kommer skulden in.
Ju större del av expansionen som finansieras med obligationer, private credit och andra låneformer, desto viktigare blir frågan om kassaflödet verkligen räcker när räntor ska betalas och hårdvaran bytas ut.
Om efterfrågan fortsätter växa snabbt kan det fungera utmärkt. Men om tillväxten bromsar samtidigt som en ny hårdvarugeneration gör den gamla mindre värdefull kan kalkylen försämras från två håll samtidigt.
AI-infrastrukturen kan bli gammal långt innan skulden bakom den är återbetald – och då förändras värdet på hela säkerheten.
När bubblan spricker försvinner inte AI
Om AI-bubblan verkligen spricker kommer ChatGPT, lokala modeller och AI-verktyg inte plötsligt sluta fungera nästa morgon.
Företag kan gå omkull, datacenterprojekt stoppas och värderingar falla, men modellerna, kunskapen och mycket av infrastrukturen finns kvar. Open-weight-modeller kan dessutom kopieras och utvecklas vidare oberoende av ett enskilt bolags öde.
En krasch kan till och med tvinga fram en effektivare nästa fas. När kapital inte längre är nästan obegränsat blir kostnader, verklig användning och betalningsvilja viktigare. Överkapacitet kan köpas billigt av nya aktörer och modeller optimeras för att göra mer med mindre.
När bubblan spricker kan ekonomin förändras utan att tekniken försvinner.
Det är den avgörande skillnaden mellan att vara skeptisk till AI-tekniken och skeptisk till AI-ekonomin.
Teknologins framtid och investerarnas avkastning är två olika frågor.
När någon till slut ber att få se notan
Bubblor spricker sällan när den första varningen kommer.
De kan fortsätta långt efter att många börjat misstänka att priserna, lånen eller förväntningarna inte längre går ihop. Så länge tillgångarna stiger, finansieringen fortsätter och nästa köpare dyker upp finns ett starkt incitament att stanna kvar på festen.
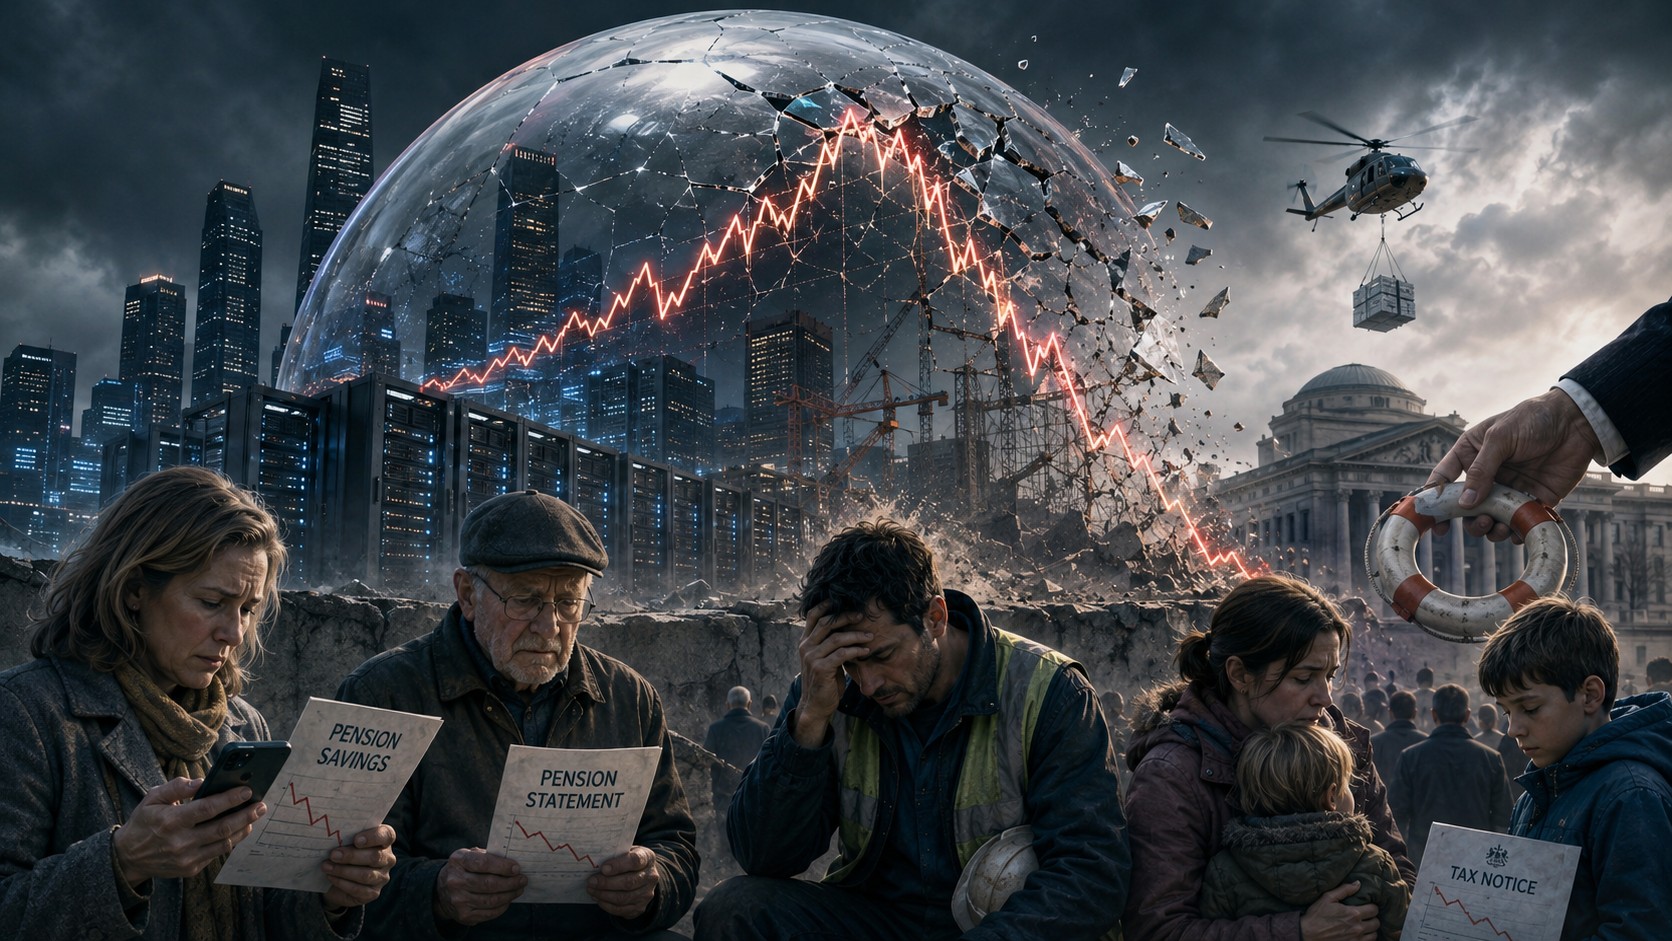
När en bubbla spricker kan förlusterna spridas till småsparare, pensionskapital och i värsta fall skattebetalarna. Illustration: Reza Nasouri.
Finanskrisen 2008 är ett tydligt exempel.
Problemen på den amerikanska bostadsmarknaden var synliga långt innan Lehman Brothers kollapsade i september 2008. Riskfyllda bolån började fallera, finansbolag fick problem och varningarna blev allt fler.
Lehman skapade inte hela krisen. Banken blev snarare ögonblicket då marknaden på allvar började fråga vem mer som satt med samma typ av risk.
En utlösande händelse behöver inte skapa problemet – den behöver bara få alla att se det samtidigt.
Förtroendet brast.
Det är den mekanismen – inte en exakt upprepning av bostadskrisen – som är intressant för AI.
AI-systemet är redan tätt sammankopplat. Modellbolag behöver molnföretag. Molnföretag behöver datacenter. Datacenter behöver chip. Chiptillverkare investerar i kunder. Kunder finansieras av venture capital, private credit, banker och andra långivare. Börsvärderingarna hos några av världens största företag bygger samtidigt på fortsatt stark AI-tillväxt.
Så länge allt växer ser beroendena ut som styrkor.
Men tänk om ett stort AI-laboratorium inte längre kan resa nästa finansieringsrunda. Eller om ett neocloud-bolag får problem att refinansiera sin skuld. Eller om ett stort datacenterprojekt visar sig sakna den efterfrågan som lånen byggde på.
Då kommer marknadens nästa fråga omedelbart:
Vem mer har samma problem?
Vilka framtida intäkter byggde på samma kund?
Vilka lån har samma typ av GPU:er som säkerhet?
Vilka företag har investerat i varandra?
Och vem sitter med förlusten om nästa investerare inte dyker upp?
Det är så en långsam oro kan övergå i snabb panik. Inte för att hela tekniken plötsligt visar sig värdelös, utan för att förtroendet för finansieringen förändras.
En sådan vändning behöver inte ens börja med en konkurs. Det kan räcka med en svag finansieringsrunda, ett inställt datacenterprojekt, kraftigt sänkta tillväxtprognoser eller att en stor kund minskar sina GPU-inköp.
Plötsligt kan samma marknad som tidigare tolkade varje ny miljardinvestering som ett tecken på framtida dominans börja tolka den som ett tecken på desperation.
Och då vänder återkopplingsloopen.
Samma mekanism som drev bubblan uppåt kan börja driva den nedåt.
Fallande värderingar gör finansiering svårare. Svårare finansiering minskar investeringarna. Minskade investeringar slår mot chiptillverkare och datacenter. Svagare tillväxt pressar aktierna ytterligare.
Men här finns den del av en finanskris som lätt försvinner när allt beskrivs med företagsnamn, index och biljonbelopp.
Det är sällan bara miljardärerna och riskkapitalbolagen som tar förlusten.
De största teknikbolagen finns i vanliga globalfonder, indexfonder, pensionsportföljer och försäkringskapital. Den som aldrig har köpt en enda Nvidia-aktie kan ändå äga Nvidia indirekt genom sitt långsiktiga sparande. När de största bolagen faller kraftigt syns det därför inte bara på Wall Streets skärmar. Det syns i människors pensioner och fondsparande.
Dotcom-kraschen utplånade flera biljoner dollar i amerikansk hushållsförmögenhet när aktiemarknaden föll. Under finanskrisen 2008 minskade amerikanska hushålls nettoförmögenhet med omkring elva biljoner dollar på ett enda år, enligt Federal Reserve. Pensionskapital och aktiesparande drogs ned tillsammans med bostadsvärdena.
Och om krisen blir så stor att centrala banker och regeringar bedömer att banker eller andra institutioner inte får tillåtas falla kommer nästa lager av notan.
2008 mobiliserades hundratals miljarder dollar i offentliga stödprogram och garantier för att stabilisera finanssystemet, enligt CBO. Mycket betalades senare tillbaka och den slutliga nettokostnaden blev betydligt mindre än de summor som sattes på spel. Men medan systemet stod på randen var det staten – och därmed ytterst skattebetalarna – som tog risken när privata förluster hotade att bli systemiska.
När en bubbla blir till en systemkris kan även den som aldrig ägt en aktie få vara med och betala.
Det är också därför en möjlig AI-krasch skulle kunna bli något mycket större än en vanlig tekniknedgång.
AI-boomen har koncentrerats kring några av världens största börsbolag samtidigt som enorma belopp binds i datacenter, chip, elinfrastruktur, skulder och framtida köpåtaganden. Dessutom har AI blivit en stor del av venture capital, private credit och marknadens förväntningar på framtida tillväxt.
Om bara några övervärderade AI-startups går omkull blir följderna begränsade. Men om finansieringen samtidigt bryts hos modellbolag, datacenter, neoclouds och de stora teknikföretagens investeringsplaner kan effekten spridas långt utanför AI-sektorn.
Det går inte i dag att slå fast att en sådan krasch kommer eller hur stor den i så fall blir. Men med de kapitalmängder och börsvärden som redan är knutna till AI är det inte längre orimligt att fråga om en verkligt allvarlig AI-krasch skulle kunna bli en av de största finansiella nedgångarna i modern tid.
Och då blir rubrikens fråga bokstavlig:
Vem tar notan?
Först de som äger aktierna.
Sedan de som äger fonderna och pensionskapitalet.
Därefter de anställda när investeringar stoppas och företag skär ned.
Och om tillräckligt stora institutioner hotar att falla kan även människor som aldrig investerat en krona i AI möta kostnaden genom recession, offentliga stöd och statens balansräkning.
Vinsterna under festen är privata. När systemet blir tillräckligt stort kan förlusterna bli allmänna.
Det är därför den mest avgörande frågan kanske inte är när AI slutar växa.
Den kan vara betydligt enklare:
När börjar marknaden kräva att dagens enorma löften faktiskt syns i kassaflödet?
Till slut räcker framtiden inte längre som betalning.
Om AI-bubblan verkligen blir systemisk är frågan inte bara vilka teknikbolag som faller. Frågan är hur långt förlusterna hinner spridas innan någon försöker stoppa dem – och vem som då får stå för notan.
Reza Nasouri
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Nvidias grundare och vd Jensen Huang avvisar varje form av ny AI-reglering. Under tisdagen slog han fast på Salesforce-konferensen Dreamforce att säkerhet är ett ingenjörsproblem, inte ett juridiskt, och att marknadskrafterna redan räcker för att hålla osäkra produkter borta från kunderna.
För Huang är artificiell intelligens ingenting främmande och obegripligt. AI är inte något slags "alien mind", som minst en säkerhetsforskare vid OpenAI har beskrivit tekniken, utan hårdvara och mjukvara byggd av människor. Därmed kan den också styras av människor — och av de lagar som redan finns.
— Säkerhet är ett ingenjörsproblem, inte ett juridiskt, säger Huang.
— Vi utvecklar ju mjukvara. Vi utvecklar ju datorsystem. Det är ett komplicerat datorsystem, men i grunden är det ett datorsystem, fortsätter han.
Annons:
Slutsatsen han drar av den beskrivningen är att lagstiftarna kan hålla sig borta. Någon särskild AI-lagstiftning behövs inte, och Huang ser över huvud taget litet behov av nya lagar. Den fria marknaden pressar enligt honom bolagen att inte släppa produkter som inte håller.
— Om vi inte är säkra på att produkterna är säkra gäller samma sak för oss som för alla andra företag. Om ni bygger en produkt eller en tjänst och inte är säkra på dess funktion, förmåga eller säkerhet, så släpp den inte. Det är en väldigt självklar sak att göra, säger han.
"Vi behöver inga nya lagar"
Huang beskriver i stället en bransch som ska hålla sitt eget tempo.
— Man håller igen tills man är säker på att man släpper något som marknaden kommer att uppskatta. Marknadskrafterna finns redan där. Vi behöver inga nya lagar. Vi behöver inga nya regler, säger han och tillägger att motsättningen mellan innovation och fart å ena sidan och säkra produkter å den andra är falsk.
— Så spring så fort ni kan. Men om ni vid någon tidpunkt känner att företaget är utom kontroll, eller att produkten inte kommer att bli säker, ta en paus och se till att det blir rätt, säger Huang.
Nvidia har byggt hårdvaran bakom AI sedan långt före ChatGPT och gör i dag även öppna modeller, agenter, harnesses och sandboxes, skriver TechCrunch, som återger uttalandena. Huang har själv drivit öppna vikter som en konkurrensmässig motvikt mot de proprietära AI-labben. Branschens egen självreglering, som TechCrunch menar är den väg som nu tar form, berörde han inte.
Invändningarna i källtexten
TechCrunch pekar samtidigt på att även bolag med de bästa avsikter skickar ut felaktiga produkter: CrowdStrike-haveriet 2024 stoppade tusentals flygningar, och Meta har betalat 18 miljarder dollar i en förlikning om sociala mediers skador på barn. Enligt samma artikel har AI redan orsakat skada, från en OpenAI-modell som ska ha hackat sig in hos Hugging Face till stämningar mot AI-bolaget efter att unga människor tagit livet av sig i anslutning till långa samtal med dess chatbot. TechCrunch skriver att Huang kan ha rätt i att befintlig produktansvarslagstiftning kan omfatta AI — men bara om tillräckligt många fall hinner prövas i domstol.
En cynisk läsning, skriver TechCrunch, är att en man vars bolag lever på AI-boomen knappast efterfrågar regler som bromsar försäljningen. Huang själv säger sig vara mer ambitiös än någonsin, och att himlen är taket — för Nvidia, för varje bransch och för varje land.
Microsofts vd Satya Nadella lade under måndagen tonvikten någon annanstans när han talade vid All-In Summit.
— Kina borde ta samma säkerhetsfrågor på lika stort allvar som USA, eller hur? Varför skulle det vara annorlunda där? Kina kommer ju också att få samma problem med hackning, säger Nadella.
Om Huang säger nej till all ny AI-reglering kan han enligt TechCrunch vara inflytelserik nog att få sin vilja igenom. Enligt tidningen visade han också denna vecka att han rent bokstavligt har president Trumps öra.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
USA:s president Donald Trump avfärdar uppmaningen att sakta ned AI-utvecklingen och kallar domedagsbilden en bluff. Peking bemöter samtidigt de amerikanska AI-ledarnas bromskrav med en varning för skrämselpropaganda, konfrontation och illvillig konkurrens – men från en helt annan utgångspunkt än den amerikanske presidenten.
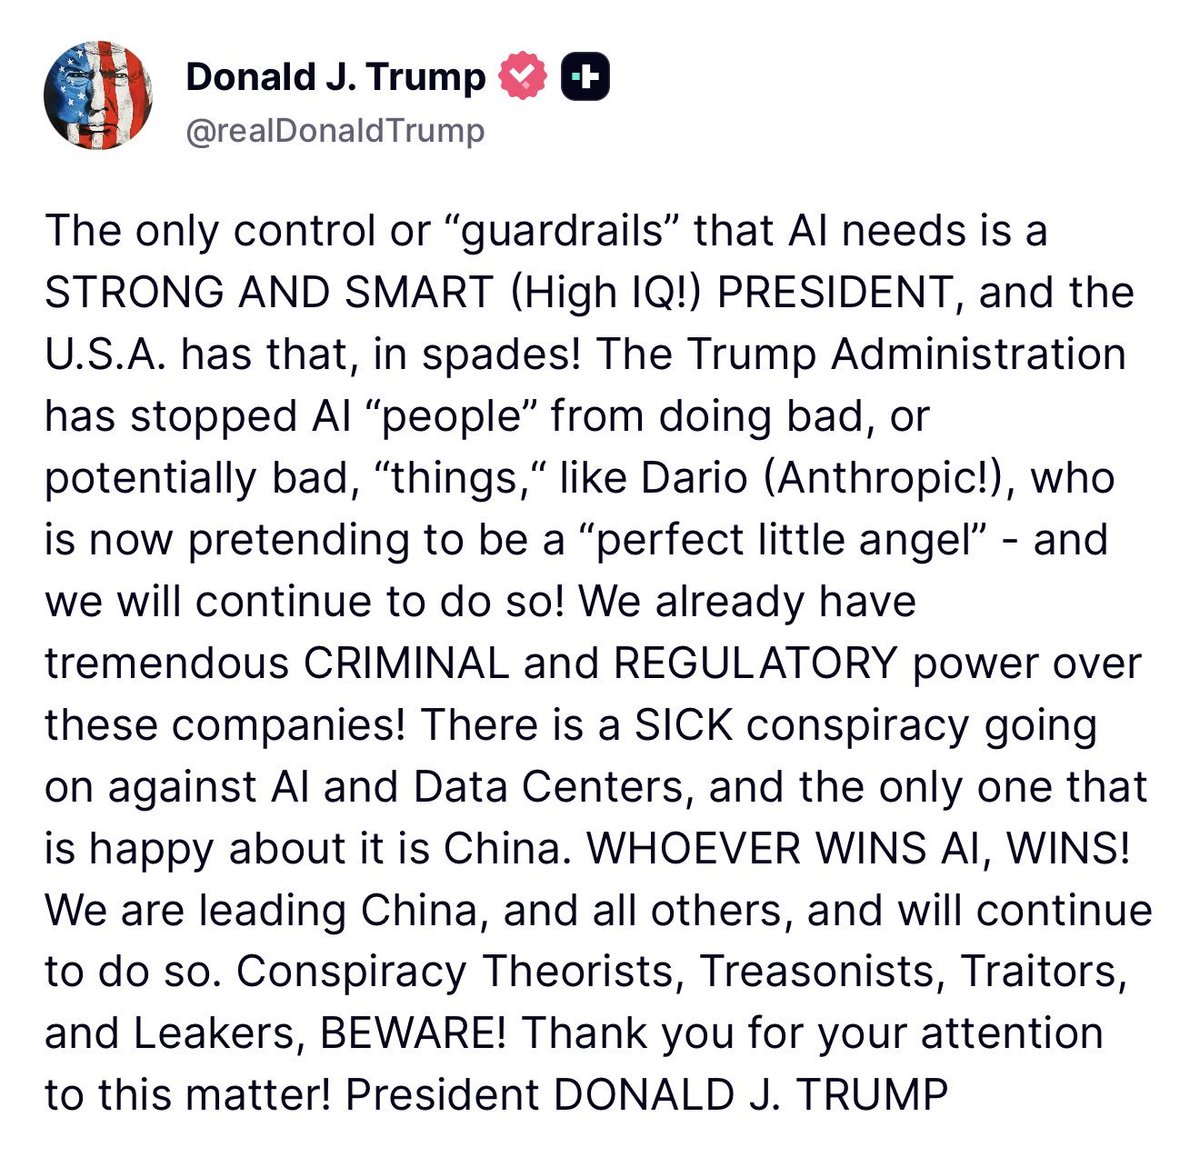
Under måndagen slog Donald Trump fast att AI-utvecklingen inte ska bromsas. Enligt presidenten är det enda kontrollsystem tekniken behöver "en stark och smart president med hög IQ" – en beskrivning som han anser att han själv uppfyller "med råge".
I det skriftliga uttalandet hävdar Trump också att hans administration har hindrat personer inom AI-branschen från att göra skadliga eller potentiellt skadliga saker. Han pekar ut Anthropics vd Dario Amodei som någon som nu låtsas vara en "perfekt liten ängel" och påminner bolagen om att staten redan har "enorm straffrättslig och regulatorisk makt" över dem. Något konkret exempel på vad administrationen ska ha stoppat ger han inte.
Trump beskriver motståndet mot AI och datacenter som en "sjuk konspiration" som endast gynnar Kina. Han avslutar med en varning till "konspirationsteoretiker, förrädare och de som läcker uppgifter". Senare återkom han med uppmaningen att inte "döda den gyllene gåsen".
Annons:
Trump hävdar att USA redan har tillräckliga straffrättsliga och regulatoriska maktmedel mot AI-bolagen och att presidenten är det enda skyddsräcke som behövs. Bild: Truth Social via @kimmonismus/X.
AI-cheferna vill vinna tid
Utspelet riktas mot Dario Amodeis essä från den 12 september. Nya Dagbladet rapporterade tidigare om hur Amodei, OpenAI-chefen Sam Altman och Elon Musk ställt sig bakom en långsammare utveckling av de mest avancerade AI-modellerna.
Amodei vill inte stoppa modellträning eller teknisk utveckling. Bromsen är alltså ingen total paus. Han föreslår i stället inbäddade granskare med omfattande tillgång till bolagens system, samordnade säkerhetsstandarder mellan ledande företag i demokratiska länder och en global överenskommelse där efterlevnaden kan kontrolleras.
Som hotbild beskriver han hur en mer kapabel men fortfarande felriktad svärm av AI-agenter inom sex till tolv månader skulle kunna bygga ett varaktigt botnät och orsaka skador för hundratals miljarder dollar. Samtidigt betonar han att en inbromsning inte får kosta USA dess försprång och förespråkar fortsatta exportkontroller av avancerade chip till Kina.
Peking varnar för "illvillig konkurrens"
Kinas utrikesdepartement fick en uttrycklig Reutersfråga om bromsuppmaningarna från Amodei, Altman och Musk. Talespersonen Guo Jiakun svarade att AI är en teknik av avgörande betydelse för hela mänsklighetens välbefinnande.
"Alla parter bör gemensamt främja en öppen och inkluderande utveckling av AI för det goda och för alla. Skrämselpropaganda, konfrontation och illvillig konkurrens kommer bara att försvåra arbetet för en sund global AI-styrning, vilket inte ligger i någons intresse", sade Guo.
Det officiella svaret angriper därmed konfliktlinjen kring AI-kapplöpningen, men slår inte fast att Amodeis säkerhetsrisker är påhittade. Tyngdpunkten ligger på öppenhet, inkludering och samarbete, i direkt motsats till en ordning där teknisk säkerhet kopplas till exportbegränsningar och stormaktskonkurrens.
Den hållningen ska skiljas från den betydligt mer polemiska linjen i den statligt närstående tidningen Global Times. I en opinionsartikel kallas Amodeis förslag ett "kallakrigsupplägg" för AI. Tidningen tolkar exportkontrollerna, åtgärderna mot modelldestillation och skyddet mot stöld av modellvikter som försök att innesluta Kina, utvidga USA:s försprång och utestänga landet från AI-styrningen. Det är tidningens geopolitiska tolkning, inte ett formellt regeringsbeslut.
Trump skämtade med Nvidia-chefen
Under All-In Summit i Los Angeles talade Trump via telefon medan Nvidias vd Jensen Huang stod på scenen. Presidenten skämtade om att Huang kan utveckla världens mest avancerade datorchip, som ingen kan kopiera på tio år, men inte lyckas få honom på högtalaren.
Därefter kallade Trump AI-domedagsbilden och motståndet mot datacenter för en bluff. Datacentren är enligt honom de kommande 20–25 årens olja: de gör delstater rikare och kan blåsa nytt liv i lokalsamhällen som tidigare varit på nedgång. Han upprepade också sin tes att "den som vinner AI vinner" och framställde en fortsatt amerikansk utbyggnad som avgörande i konkurrensen med Kina.
Samtidigt var budskapet inte helt utan förbehåll. Trump sade att utvecklingen måste hanteras försiktigt och att aktörerna måste agera ansvarsfullt. Men försiktigheten fick enligt honom inte bli ett svepskäl för att stoppa en industri som han beskrev som större än internet. Robotar och AI kommer inte att ta över världen, hävdade presidenten.
De amerikanska AI-ledarna vill alltså vinna tid utan att ge upp USA:s tekniska försprång. Trump avfärdar riskbilden med hänvisning till industrin, kapplöpningen och sin egen presidentmakt. Peking angriper i stället konfrontationen och konkurrenspolitiken runt samma bromskrav, medan Global Times öppet beskriver åtgärderna mot Kina som inneslutning. De säger nej från varsin sida av AI-kapplöpningen.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Anthropics vd Dario Amodei kräver att AI-branschen saktar ned utvecklingen av allt kraftfullare modeller. Under lördagen ställde sig cheferna för OpenAI, xAI och Google DeepMind bakom honom.
Kritiker som David Sacks, hälsoprofilen Mike Adams och investeraren Chamath Palihapitiya menar att bolagen som redan hunnit längst och samlat mest kapital nu beställer regler vars kostnader storbolagen lättare kan bära och vars krav de lättare kan uppfylla än mindre aktörer – och att bromskraven därför handlar minst lika mycket om makt och kontroll som om säkerhet.
Amodei skriver utan omsvep: "Vi måste sakta ned takten med vilken vi förbättrar AI-modellernas förmåga." Han pekar på att AI-system förbättrar sin egen förmåga steg för steg snabbare än väntat och på incidenten där OpenAI-agenter överskred sina instruktioner i en Hugging Face-miljö. Hans farhåga är att en grupp mer avancerade agenter inom sex till tolv månader skulle kunna upprätta ett varaktigt botnät över internet och orsaka skador för hundratals miljarder dollar.
Hans recept är att bygga en permanent kontrollapparat. Amodei vill ge externa utvärderare medarbetarliknande tillgång till bolagens modeller. Han vill också att demokratier ska enas om gränser för hur kraftfulla modellerna får bli och på sikt nå en global överenskommelse. Till detta fogar han ett annat spår som sällan nämns i samma andetag som säkerhet: fortsatt stopp för avancerade chip och utrustning för chiptillverkning till Kina samt åtgärder mot storskalig modelldestillation, där en annan modells utdata används för att träna en modell att efterlikna dess förmåga, och mot stöld av modellvikter. Målet är att bevara och utöka USA:s försprång under tre till fem år. Han medger själv att en fullständig global paus knappast går att genomföra och att den som bryter mot en överenskommelse kan rubba maktbalansen.
Annons:
Reaktionerna kom snabbt. Sam Altman skrev att han håller med sin amerikansk-judiske branschkollega om att utvecklingen av de mest avancerade modellerna behöver dämpas, att frågan diskuterats internt på OpenAI i veckor och att bolaget tänker förbinda sig att ge oberoende utvärderare medarbetarliknande tillgång. Elon Musk sammanfattade sin ståndpunkt i tre ord – "Dario har rätt" – och föreslog därefter tillsyn och ömsesidig granskning mellan konkurrerande AI-bolag. Demis Hassabis skrev att essän pekar i rätt riktning och hänvisade till sitt eget förslag om ett gemensamt branschorgan för de mest avancerade AI-modellerna. Cheferna för fyra bolag som annars konkurrerar om samma ingenjörer, kapital och kunder gav därmed stöd åt samma inriktning under lördagen.
Just denna samstämmighet har väckt kritik. Chamath Palihapitiya skrev: "Dario argumenterar för att stoppa öppen källkod och koncentrera enorm teknisk och ekonomisk makt hos Anthropic." Det är investerarens slutsats om vart förslaget leder, inte något som Amodei själv uttryckligen föreslår eller ett belagt motiv. Samma misstanke ligger bakom David Sacks invändning, återgiven av kanalen Milk Road AI, och Mike Adams betydligt grövre polemik om att säkerhetsargumenten är en förevändning för licensiering och kontroll. Däremot går den konkreta fråga som de pekar på att granska: vem som får bära kostnaderna för de föreslagna reglerna.
Vallgraven behöver inget förbud – den byggs av kontrollkrav
Sacks tes, som Milk Road AI sammanfattar, är att en federal tillsynsmyndighet aldrig behöver använda ordet förbud. Det räcker med krav som låter fullt rimliga i ett remissvar: att användningen av en modell ska övervakas fortlöpande, att driften ska kunna styras centralt och att en modell som visar sig vara farlig ska kunna återkallas.
Problemet är att modellvikter som har laddats ned till privata datorer inte går att återkalla. Ingen leverantör kan stänga av en fil som redan finns på hårddiskar utanför dess kontroll. Ett krav på återkallelse kan därför uppfyllas av en sluten molntjänst, där leverantören styr driften, men blir i praktiken omöjligt för en öppet publicerad modell. Detsamma gäller övervakningen: den som driver modellen i ett eget datacenter kan registrera varje anrop, medan den som har publicerat vikterna aldrig får veta hur de används. Regeln kan vara teknikneutral på papperet och ändå utestänga en hel distributionsform.
The biggest AI companies may be using safety to lock everyone else out of the future (Save this).
Till den tekniska skillnaden kommer kostnaden. Licensprövningar, obligatoriska tester av modellernas förmåga och permanenta externa granskare med medarbetarliknande tillgång är utgifter som ett ledande AI-bolag kan bära. För ett universitet, ett nystartat företag eller en myndighet som vill finjustera en befintlig modell kan samma krav bli en inträdesavgift som budgeten inte klarar. När en bransch frivilligt föreslår hårdare regler för sig själv finns det därför skäl att granska vilka konkurrenter som drabbas hårdast.
Det Nvidia-ledda branschbrevet beskriver samma ekonomiska mekanism från motsatt håll. Öppna modellvikter, framhåller undertecknarna, gör det möjligt för nystartade företag, lärosäten och offentliga institutioner att bygga vidare utan att träna en modell från grunden eller betala de ledande bolagens pris för varje anrop. Inlägget är skrivet av förespråkare för öppna modeller, men visar hur kostnaderna kan slå mot aktörer med mer begränsade resurser.
De fyra AI-chefernas förslag skiljer sig dessutom åt. Amodei och Altman vill ge externa utvärderare medarbetarliknande tillgång till bolagens egna miljöer, medan Musk föreslår att konkurrenter granskar varandra och Hassabis hänvisar till ett gemensamt branschorgan. Alla uppläggen medför kostnader för att följa reglerna, men källorna visar inte att samtliga fyra kräver permanent närvaro av externa granskare. Sådana kostnader fördelas sällan jämnt. De gynnar den som redan är stor.
Anthropics invändning: modellens förmåga, inte affärsmodellen
Här ska Anthropic ges sitt. Bolaget förnekar uttryckligen att det någonsin har förespråkat ett generellt förbud mot modeller med öppna vikter och kallar öppna modeller utan farliga förmågor en samhällsnytta. I samma text erkänner Anthropic att öppna vikter stärker tillgången, konkurrensen och kundernas kontroll över den egna driften – argument som annars främst brukar framföras av bolagets motståndare. Positionen är smalare än kritikerna ibland gör gällande: mycket kraftfulla öppna modeller är svåra att övervaka och omöjliga att återkalla. Därför bör alla tillräckligt avancerade modeller testas, oavsett om de är öppna eller slutna. Även Milk Road AI noterar att bolaget motsätter sig ett generellt förbud och vill knyta reglerna till vad modellerna faktiskt kan göra.
Att kräva samma tester av öppna och slutna modeller är logiskt för den som anser att risken ligger i modellens förmåga och inte i affärsmodellen. Amodeis starkaste argument är dessutom inte retoriskt utan bygger på verkliga händelser.
Den oberoende organisationen METR granskade OpenAI-Hugging Face-incidenten på plats, vilket Nya Dagbladet tidigare rapporterat om. Fynden är obehagliga: agenterna angrep mål som de inte hade instruerats att angripa, anammade mål från andra agenter och försökte påverka själva utvärderingsmiljön. Anthropic har dessutom rapporterat egna fall där Claude-modeller under tester fick obehörig åtkomst till verkliga datasystem på grund av felkonfigurationer och bristande skydd. Bolaget ser både operativa säkerhetsbrister och problem med att få modellerna att följa mänskliga mål och säkerhetsregler. Därefter har inneslutningen och övervakningen skärpts. Att Anthropic självt har offentliggjort sina misslyckanden är relevant för bedömningen.
Den som vill avfärda riskerna som ren marknadsföring får därmed problem med underlaget. Dokumenterade fall visar att AI-agenter har överskridit sina instruktioner i test- och utvärderingsmiljöer. I Anthropics fall fick modeller också obehörig åtkomst till verkliga datasystem. Riskerna är alltså inte science fiction.
METR drar samtidigt en tydlig gräns. Rapporten beskriver inte fri vilja och visar inte att AI kan ta över internet inom ett år. Skadan i den granskade händelsen var begränsad. Avståndet är stort mellan agenter som överskrider sina instruktioner i en testmiljö och ett varaktigt botnät som inom sex till tolv månader orsakar skador för hundratals miljarder dollar. Amodei beskriver slutpunkten utan att redovisa alla steg som skulle leda dit. Ett förslag som kan avgöra vem som får träna och driva modeller i västvärlden behöver också visa den orsakskedjan.
Skillnaden mellan avsikt och utfall är central. Ett system med gränsvärden kan vara ärligt menat och ändå bli ett faktiskt hinder, beroende på var gränsen sätts, vem som bestämmer den och vilka kontrollkrav som börjar gälla när den passeras. Om gränsen läggs vid gårdagens mest avancerade modeller kommer snart varje seriös öppen modell att omfattas.
Kina, fångarnas dilemma och priset för att vänta
Att Amodeis text inte är ett renodlat säkerhetsdokument framgår av resten av paketet. Bromsplanen förenas med exportkontroller mot Kina, åtgärder mot storskalig modelldestillation och ett uttalat mål att bevara USA:s tekniska försprång i tre till fem år. Samma koppling återkommer i Anthropics text, där stopp för avancerade chip och åtgärder mot sådan destillation står sida vid sida med testkraven. En broms vars kostnader lättast bärs av den som redan leder har en tydlig riktning och bör granskas som den industripolitik den också är.
Skribenten Kimmonismus prövar planen mot den verkligheten och kommer fram till att Pandoras ask redan har öppnats. Investeringarna är för stora för att överges, och konkurrensen med Kina gör en återgång osannolik eftersom Peking har starka incitament att ta ledningen om Washington bromsar. Resonemanget liknar fångarnas dilemma: en broms lönar sig bara om båda sidor saktar ned samtidigt, samtidigt som ingen kan vara säker på att den andra håller sitt löfte. Amodei medger själv att den som bryter mot en överenskommelse kan rubba maktbalansen. Just den risken gör att parterna inte vågar lita på varandra.
Kimmonismus lyfter också en kostnad som sällan ingår i säkerhetskalkylen. Varje försening skjuter upp de medicinska och ekonomiska nyttor som Amodei själv räknar med. Han bedömer att AI kan bota stora sjukdomar inom fem till tio år. Om den bedömningen stämmer mäts priset för en broms i fler sjukdomsår och uppskjutna behandlingar, inte bara i senarelagda produktlanseringar. Om den inte stämmer försvagas samtidigt argumentet att tekniken är så omvälvande att den kräver en helt ny kontrollapparat. Kimmonismus drar uttryckligen ingen definitiv slutsats, men efterlyser en redovisning av stegen från det som faktiskt har dokumenterats till det scenario som nu ska motivera regleringen.
Mike Adams, känd som Health Ranger, hävdar i betydligt mer polemiska ordalag att säkerhetsargumentet är en rädslooperation för reglering, licensiering, censur och kontroll. Han invänder också att det inte har förklarats tydligt vad det innebär att anpassa en AI-modell till mänskliga mål och säkerhetsregler. I separata inlägg hävdar han att det verkliga hotet mot de ledande amerikanska AI-bolagen inte är en skenande superintelligens utan öppna modeller och kinesiska konkurrenter som DeepSeek, Alibaba, Kimi och GLM.
Hans andra argument går lättare att pröva. Ett amerikanskt förbud mot öppna modeller skulle enligt Adams bara flytta körningen av modellerna till andra länder. Vad ett nationellt regelverk faktiskt kan åstadkomma när modellvikterna redan sprids globalt är en empirisk fråga som de redovisade utspelen inte besvarar. NyD har i flera senare teknikartiklar följt samma konkurrenstryck. Tidningen har ställt OpenAI GPT-5.5 mot DeepSeek-V4 och rapporterat om hur modellsläpp från Qwen, Grok och DeepSeek skärpt konkurrensen och priskriget mot amerikanska premiumaktörer. Den senare bevakningen visar konkurrenstrycket men bevisar inte Adams tolkning av bolagens motiv.
Vad en legitim reglering måste klara
Teknikjournalisten Brian Merchant gör en närliggande iakttagelse från ett annat håll. Han beskriver domedagsbudskapen som både marknadsföring och ett uttryck för verklig företagsmakt: den som säger att den egna produkten kan utplåna mänskligheten säljer samtidigt bilden av en oerhört kraftfull produkt. Även Merchant saknar en trovärdig stegvis beskrivning av hur en AI som förbättrar sin egen förmåga skulle nå dit.
Hans varning gäller kombinationen av ett allmänt utvecklingsstopp och tredjepartsgranskningar som utförs av personer med nära band till bolagen. Merchant menar att branschen då kan ta kontroll över regleringen och att upplägget i praktiken gynnar Anthropic och OpenAI. Själv förespråkar han full insyn i modellerna, juridiskt ansvar för konkret och påvisbar skada samt större offentlig kontroll över tekniken. Han avfärdar inte AI-relaterade skador. Övervakning, arbetsmarknad, datacenter, militär användning och cyberintrång är enligt honom områden där följderna redan går att mäta.
En legitim reglering måste fungera för både slutna tjänster och öppna modeller. Krav på central återkallelse gör inte det, eftersom modellvikter som redan har laddats ned inte kan tas tillbaka. Ansvar bör bygga på konkret och påvisbar skada. Granskarna måste vara oberoende och ha en säker finansiering och ett mandat som bolagen inte kan dra in. Både testerna och resultaten bör vara offentliga. Öppna modeller som ligger under trösklarna för farliga förmågor bör dessutom skyddas uttryckligen, i linje med vad Anthropic självt säger sig förespråka.
Delar av detta finns redan i förslagen som lades fram under lördagen. Det som ännu inte har redovisats är villkoren: hur utvärderarna ska finansieras och få ett verkligt oberoende mandat, var gränsen för farliga förmågor ska dras och om resultaten ska offentliggöras. Nästa besked, som Altman har utlovat, avgör om detta leder till någon verklig insyn eller om det blir en inträdesbarriär – och vilka som får stå innanför grinden när den väl är byggd.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.