

Anthropic lanserar Claude Opus 4.8 som en uppgradering av bolagets tyngsta AI-modell. Fokus ligger inte på småprat, utan på längre arbetsflöden, kodning och autonoma agentuppgifter – samtidigt som bolagets eget säkerhetskort visar att mer självständiga AI-system också skapar nya risker.
AI-bolaget meddelar att Claude Opus 4.8 nu är tillgänglig för användare och utvecklare. Modellen bygger vidare på Opus 4.7 och beskrivs av Anthropic som starkare i omdöme, kodning, professionellt kunskapsarbete och längre uppgifter där AI-systemet arbetar mer självständigt.
Lanseringen ligger helt i linje med den riktning som hela AI-branschen nu rör sig mot: från chattbotar som svarar på frågor till agenter som tar emot ett uppdrag, planerar arbetet, använder verktyg, skriver kod, kör tester och rapporterar tillbaka först när arbetet är klart.
I lanseringstråden på X beskriver Claude-kontot Opus 4.8 som en modell med skarpare omdöme, större ärlighet om sin egen arbetsprocess och bättre förmåga att arbeta självständigt under längre tid än tidigare modeller.
Introducing Claude Opus 4.8: it builds on Opus 4.7 with sharper judgment, more honesty about its own progress, and the ability to work independently for longer than its predecessors.
— Claude (@claudeai) May 28, 2026
Available today at the same price. pic.twitter.com/EufxL7T1kb
AI-agenter i centrum
Den största nyheten är inte bara själva modellen, utan hur Anthropic vill att den ska användas. Claude Code får funktionen ”dynamic workflows” i en tidig testversion. Enligt bolaget kan Claude där planera större utvecklingsprojekt, starta många parallella underagenter, verifiera resultatet och arbeta mot en färdig kodändring i stora kodbaser.
Anthropic beskriver exempelvis kodmigreringar över hundratusentals rader som en typisk uppgift. Tidigare krävdes en grupp utvecklare, flera sprintar och kontinuerlig mänsklig uppföljning. Nu säljs visionen som en arbetskamrat som kan hålla fokus under längre arbetspass.
Opus 4.8 får också så kallad effort control, där användaren kan välja hur mycket beräkningsarbete modellen ska lägga på ett svar. Högre effort ska ge bättre resultat men förbruka mer resurser, medan lägre effort ger snabbare svar och lägre belastning på användarens kvoter.
Starkare benchmarkar – men inte överallt
I prestandatesterna visar Anthropic förbättringar jämfört med Opus 4.7 i en rad tester. I SWE-bench Pro anges Opus 4.8 till 69,2 procent, jämfört med 64,3 procent för Opus 4.7. I Humanity’s Last Exam redovisar bolaget 49,8 procent utan verktyg och 57,9 procent med verktyg.
Modellen uppges också nå 83,4 procent i OSWorld-Verified, ett test för datoranvändning, och 74,6 procent i Terminal-Bench 2.1. Samtidigt visar systemkortet att Opus 4.8 inte vinner varje jämförelse. I Terminal-Bench 2.1 ligger GPT-5.5 högre, och i GPQA Diamond ligger både Opus 4.7 och Gemini 3.1 Pro marginellt före.
Denna brasklapp är viktig. AI-bolagens benchmarkbilder är marknadsföringsmaterial, även när de bygger på verkliga tester. Siffrorna visar förmåga, men inte nödvändigtvis hur väl en modell fungerar i en pressad redaktionsmiljö, ett företags interna system eller ett samhällskritiskt arbetsflöde.
Samma baspris – dyrare snabbläge
Det ordinarie API-priset är oförändrat: 5 dollar per miljon indatatokens och 25 dollar per miljon utdatatokens. Enligt dokumentationen har Opus 4.8 ett kontextfönster på upp till en miljon tokens och maximal utdata på 128 000 tokens. På Microsoft Foundry är kontextfönstret dock begränsat till 200 000 tokens.
Anthropic lyfter samtidigt fram ett snabbare läge som ska ge 2,5 gånger högre hastighet. Fast mode kostar 10 dollar per miljon indatatokens och 50 dollar per miljon utdatatokens. Läget är alltså dyrare än normalpriset, men enligt bolaget tre gånger billigare än tidigare snabbläge.
För konsumenter finns modellen på Claude för Pro, Max, Team och Enterprise. För utvecklare finns den via Claude API, AWS, Google Cloud och Microsoft Foundry under modellnamnet claude-opus-4-8.
Säkerhetskortet visar kvarstående risker
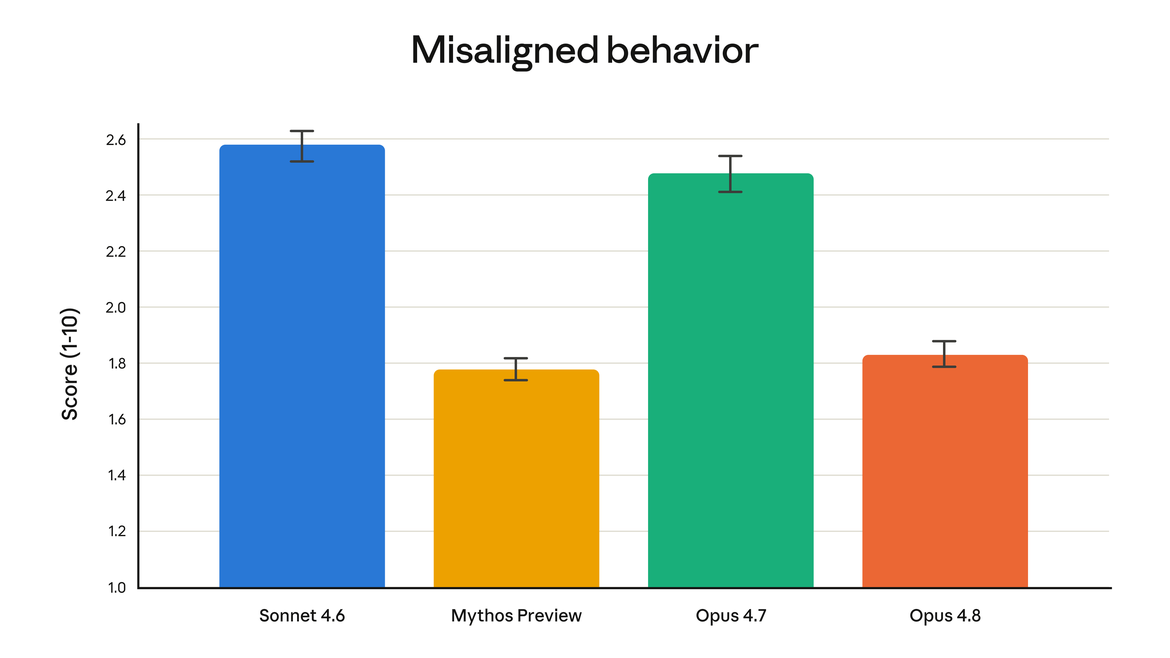
Anthropic framhåller i lanseringen att Opus 4.8 har blivit mer ”ärlig” i miljöer där AI:n agerar mer självständigt. Bolaget uppger bland annat att modellen löper omkring fyra gånger mindre risk än föregångaren att missa brister i sin egen kod.
Men samma säkerhetskort ger också en mer nykter bild. Anthropic skriver att Opus 4.8 i flera autonoma sammanhang var mindre robust än Opus 4.7, bland annat när det gäller sårbarhet för så kallade instruktionsattacker (prompt injection). Bolaget hävdar att skyddsåtgärder i praktiken minskar gapet, men själva mönstret är värt att notera.
Ju mer AI-system får göra själva, desto större blir konsekvensen när de vilseleds. En chattbot som ger ett dåligt svar kan rättas av användaren. En agent som redan har fått tillgång till kodbaser, filer, webbläsare, terminaler och molntjänster kan hinna göra betydligt mer innan någon upptäcker felet.
Claude Opus 4.8 är därför både en imponerande produktlansering och ett tecken på hur makten över det digitala arbetet förskjuts. Framtidens AI-fråga handlar inte bara om vilken modell som svarar bäst. Den handlar om vem som får sätta gränserna när modellen börjar agera.