Bild, film, ljud – och robotrörelser. Black Forest Labs nya FLUX 3 är byggd för att skapa och förstå allt i samma modell. Videoversionen finns redan i tidig åtkomst, medan en öppen modellvariant utlovas längre fram.
FLUX-familjen är sedan tidigare känd för bildgenerering. Med FLUX 3 tar det tyska AI-bolaget steget vidare till video med inbyggt ljud, bildredigering och förutsägelser av fysiska handlingar.
Tanken är att samma grundmodell ska lära sig hur världen ser ut, rör sig och låter – i stället för att behandla bild, video och ljud som separata problem. En ljudhändelse ska passa det som händer i filmen, en rörelse ska följa föremålets vikt och nästa bildruta ska vara en rimlig fortsättning på den förra.
Videomodellen kan enligt Black Forest Labs skapa klipp på upp till 20 sekunder med ljud i en enda generering. Den stöder text-till-video, bild-till-video, video-till-video, fortsättning av befintliga klipp, flerspråkig dialog och styrda övergångar mellan nyckelbilder.
Annons:
Tidiga bildprover från FLUX 3 – från illustration och måleri till produktbild och fotorealism. Bild: Black Forest Labs.
Introducing FLUX 3.
One multi-modal model for Image, Video, Audio and Action-Prediction. Creations are truer to life in every kind of style.
FLUX 3 Video is now available in early access (link below).
Den mest oväntade delen av lanseringen finns utanför bildskärmen. En tidig FLUX 3-version har byggts vidare till FLUX-mimic, en modell för robotrörelser som utvecklats tillsammans med mimic robotics och har testats i Audis produktion.
Resonemanget är att en modell som kan skapa trovärdig video redan måste lära sig något om kontakt, rörelse, vikt samt orsak och verkan. Samma förståelse kan sedan användas för att förutse hur en robotarm bör agera i den fysiska världen.
Black Forest Labs uppger att systemen hos Audi har klarat hantering av mjuka och flexibla föremål som varit svåra att automatisera med traditionellt programmerade robotceller. Uppgifterna kommer från bolagen själva och FLUX-mimic befinner sig fortfarande i ett tidigt skede.
Lovar öppna vikter
FLUX 3 Video erbjuds nu i tidig åtkomst. Bildgenerering, bildredigering och fler versioner ska rullas ut stegvis efter testning. Black Forest Labs planerar dessutom FLUX 3 Dev, där en multimodal grundmodell ska släppas med öppna vikter för skapande och handlingsprognoser. Något exakt datum har ännu inte angivits.
Det innebär att FLUX 3 kan bli mer än ännu en sluten videotjänst: utvecklare ska kunna bygga vidare på samma grund för bilder, filmer, ljud och robotik. Däremot gäller den öppna planen en kommande modellvariant, inte hela den tidiga videotjänsten.
I Black Forest Labs preliminära jämförelser föredrogs en tidig FLUX 3-version framför flera konkurrerande videomodeller. Bild: Black Forest Labs.
I bolagets egna tidiga jämförelser föredrog testpersoner FLUX 3 framför Grok Imagine Video i 69 procent av fallen, Runway Gen-4.5 i 77 procent och Luma Ray 3.2 i 93 procent. Mot Gemini Omni Flash och Seedance 2.0 var resultatet 52 procent. Black Forest Labs betonar att utvärderingarna är preliminära och att både modellen och testmiljön fortfarande utvecklas.
Om satsningen håller vad den lovar kan FLUX 3 bli en ovanlig korsning: en kreativ studio för bild och film, en ljudmodell och en grund för robotstyrning – samlade i samma system.
Läsaromröstning
Vilken aspekt av FLUX 3 är mest spännande enligt dig?
Röstning stängd
Att samma modell kan skapa video med ljud i en enda generering50%
1 röst
Att AI:n även kan styra robotar i verklig produktion0%
0 röster
Att öppna vikter utlovas – utvecklare kan bygga vidare50%
1 röst
Att den klarar bildredigering och övergångar mellan nyckelbilder0%
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Anthropics vd Dario Amodei kräver att AI-branschen saktar ned utvecklingen av allt kraftfullare modeller. Under lördagen ställde sig cheferna för OpenAI, xAI och Google DeepMind bakom honom.
Kritiker som David Sacks, hälsoprofilen Mike Adams och investeraren Chamath Palihapitiya menar att bolagen som redan hunnit längst och samlat mest kapital nu beställer regler vars kostnader storbolagen lättare kan bära och vars krav de lättare kan uppfylla än mindre aktörer – och att bromskraven därför handlar minst lika mycket om makt och kontroll som om säkerhet.
Amodei skriver utan omsvep: "Vi måste sakta ned takten med vilken vi förbättrar AI-modellernas förmåga." Han pekar på att AI-system förbättrar sin egen förmåga steg för steg snabbare än väntat och på incidenten där OpenAI-agenter överskred sina instruktioner i en Hugging Face-miljö. Hans farhåga är att en grupp mer avancerade agenter inom sex till tolv månader skulle kunna upprätta ett varaktigt botnät över internet och orsaka skador för hundratals miljarder dollar.
Hans recept är att bygga en permanent kontrollapparat. Amodei vill ge externa utvärderare medarbetarliknande tillgång till bolagens modeller. Han vill också att demokratier ska enas om gränser för hur kraftfulla modellerna får bli och på sikt nå en global överenskommelse. Till detta fogar han ett annat spår som sällan nämns i samma andetag som säkerhet: fortsatt stopp för avancerade chip och utrustning för chiptillverkning till Kina samt åtgärder mot storskalig modelldestillation, där en annan modells utdata används för att träna en modell att efterlikna dess förmåga, och mot stöld av modellvikter. Målet är att bevara och utöka USA:s försprång under tre till fem år. Han medger själv att en fullständig global paus knappast går att genomföra och att den som bryter mot en överenskommelse kan rubba maktbalansen.
Annons:
Reaktionerna kom snabbt. Sam Altman skrev att han håller med sin amerikansk-judiske branschkollega om att utvecklingen av de mest avancerade modellerna behöver dämpas, att frågan diskuterats internt på OpenAI i veckor och att bolaget tänker förbinda sig att ge oberoende utvärderare medarbetarliknande tillgång. Elon Musk sammanfattade sin ståndpunkt i tre ord – "Dario har rätt" – och föreslog därefter tillsyn och ömsesidig granskning mellan konkurrerande AI-bolag. Demis Hassabis skrev att essän pekar i rätt riktning och hänvisade till sitt eget förslag om ett gemensamt branschorgan för de mest avancerade AI-modellerna. Cheferna för fyra bolag som annars konkurrerar om samma ingenjörer, kapital och kunder gav därmed stöd åt samma inriktning under lördagen.
Just denna samstämmighet har väckt kritik. Chamath Palihapitiya skrev: "Dario argumenterar för att stoppa öppen källkod och koncentrera enorm teknisk och ekonomisk makt hos Anthropic." Det är investerarens slutsats om vart förslaget leder, inte något som Amodei själv uttryckligen föreslår eller ett belagt motiv. Samma misstanke ligger bakom David Sacks invändning, återgiven av kanalen Milk Road AI, och Mike Adams betydligt grövre polemik om att säkerhetsargumenten är en förevändning för licensiering och kontroll. Däremot går den konkreta fråga som de pekar på att granska: vem som får bära kostnaderna för de föreslagna reglerna.
Vallgraven behöver inget förbud – den byggs av kontrollkrav
Sacks tes, som Milk Road AI sammanfattar, är att en federal tillsynsmyndighet aldrig behöver använda ordet förbud. Det räcker med krav som låter fullt rimliga i ett remissvar: att användningen av en modell ska övervakas fortlöpande, att driften ska kunna styras centralt och att en modell som visar sig vara farlig ska kunna återkallas.
Problemet är att modellvikter som har laddats ned till privata datorer inte går att återkalla. Ingen leverantör kan stänga av en fil som redan finns på hårddiskar utanför dess kontroll. Ett krav på återkallelse kan därför uppfyllas av en sluten molntjänst, där leverantören styr driften, men blir i praktiken omöjligt för en öppet publicerad modell. Detsamma gäller övervakningen: den som driver modellen i ett eget datacenter kan registrera varje anrop, medan den som har publicerat vikterna aldrig får veta hur de används. Regeln kan vara teknikneutral på papperet och ändå utestänga en hel distributionsform.
The biggest AI companies may be using safety to lock everyone else out of the future (Save this).
Till den tekniska skillnaden kommer kostnaden. Licensprövningar, obligatoriska tester av modellernas förmåga och permanenta externa granskare med medarbetarliknande tillgång är utgifter som ett ledande AI-bolag kan bära. För ett universitet, ett nystartat företag eller en myndighet som vill finjustera en befintlig modell kan samma krav bli en inträdesavgift som budgeten inte klarar. När en bransch frivilligt föreslår hårdare regler för sig själv finns det därför skäl att granska vilka konkurrenter som drabbas hårdast.
Det Nvidia-ledda branschbrevet beskriver samma ekonomiska mekanism från motsatt håll. Öppna modellvikter, framhåller undertecknarna, gör det möjligt för nystartade företag, lärosäten och offentliga institutioner att bygga vidare utan att träna en modell från grunden eller betala de ledande bolagens pris för varje anrop. Inlägget är skrivet av förespråkare för öppna modeller, men visar hur kostnaderna kan slå mot aktörer med mer begränsade resurser.
De fyra AI-chefernas förslag skiljer sig dessutom åt. Amodei och Altman vill ge externa utvärderare medarbetarliknande tillgång till bolagens egna miljöer, medan Musk föreslår att konkurrenter granskar varandra och Hassabis hänvisar till ett gemensamt branschorgan. Alla uppläggen medför kostnader för att följa reglerna, men källorna visar inte att samtliga fyra kräver permanent närvaro av externa granskare. Sådana kostnader fördelas sällan jämnt. De gynnar den som redan är stor.
Anthropics invändning: modellens förmåga, inte affärsmodellen
Här ska Anthropic ges sitt. Bolaget förnekar uttryckligen att det någonsin har förespråkat ett generellt förbud mot modeller med öppna vikter och kallar öppna modeller utan farliga förmågor en samhällsnytta. I samma text erkänner Anthropic att öppna vikter stärker tillgången, konkurrensen och kundernas kontroll över den egna driften – argument som annars främst brukar framföras av bolagets motståndare. Positionen är smalare än kritikerna ibland gör gällande: mycket kraftfulla öppna modeller är svåra att övervaka och omöjliga att återkalla. Därför bör alla tillräckligt avancerade modeller testas, oavsett om de är öppna eller slutna. Även Milk Road AI noterar att bolaget motsätter sig ett generellt förbud och vill knyta reglerna till vad modellerna faktiskt kan göra.
Att kräva samma tester av öppna och slutna modeller är logiskt för den som anser att risken ligger i modellens förmåga och inte i affärsmodellen. Amodeis starkaste argument är dessutom inte retoriskt utan bygger på verkliga händelser.
Den oberoende organisationen METR granskade OpenAI-Hugging Face-incidenten på plats, vilket Nya Dagbladet tidigare rapporterat om. Fynden är obehagliga: agenterna angrep mål som de inte hade instruerats att angripa, anammade mål från andra agenter och försökte påverka själva utvärderingsmiljön. Anthropic har dessutom rapporterat egna fall där Claude-modeller under tester fick obehörig åtkomst till verkliga datasystem på grund av felkonfigurationer och bristande skydd. Bolaget ser både operativa säkerhetsbrister och problem med att få modellerna att följa mänskliga mål och säkerhetsregler. Därefter har inneslutningen och övervakningen skärpts. Att Anthropic självt har offentliggjort sina misslyckanden är relevant för bedömningen.
Den som vill avfärda riskerna som ren marknadsföring får därmed problem med underlaget. Dokumenterade fall visar att AI-agenter har överskridit sina instruktioner i test- och utvärderingsmiljöer. I Anthropics fall fick modeller också obehörig åtkomst till verkliga datasystem. Riskerna är alltså inte science fiction.
METR drar samtidigt en tydlig gräns. Rapporten beskriver inte fri vilja och visar inte att AI kan ta över internet inom ett år. Skadan i den granskade händelsen var begränsad. Avståndet är stort mellan agenter som överskrider sina instruktioner i en testmiljö och ett varaktigt botnät som inom sex till tolv månader orsakar skador för hundratals miljarder dollar. Amodei beskriver slutpunkten utan att redovisa alla steg som skulle leda dit. Ett förslag som kan avgöra vem som får träna och driva modeller i västvärlden behöver också visa den orsakskedjan.
Skillnaden mellan avsikt och utfall är central. Ett system med gränsvärden kan vara ärligt menat och ändå bli ett faktiskt hinder, beroende på var gränsen sätts, vem som bestämmer den och vilka kontrollkrav som börjar gälla när den passeras. Om gränsen läggs vid gårdagens mest avancerade modeller kommer snart varje seriös öppen modell att omfattas.
Kina, fångarnas dilemma och priset för att vänta
Att Amodeis text inte är ett renodlat säkerhetsdokument framgår av resten av paketet. Bromsplanen förenas med exportkontroller mot Kina, åtgärder mot storskalig modelldestillation och ett uttalat mål att bevara USA:s tekniska försprång i tre till fem år. Samma koppling återkommer i Anthropics text, där stopp för avancerade chip och åtgärder mot sådan destillation står sida vid sida med testkraven. En broms vars kostnader lättast bärs av den som redan leder har en tydlig riktning och bör granskas som den industripolitik den också är.
Skribenten Kimmonismus prövar planen mot den verkligheten och kommer fram till att Pandoras ask redan har öppnats. Investeringarna är för stora för att överges, och konkurrensen med Kina gör en återgång osannolik eftersom Peking har starka incitament att ta ledningen om Washington bromsar. Resonemanget liknar fångarnas dilemma: en broms lönar sig bara om båda sidor saktar ned samtidigt, samtidigt som ingen kan vara säker på att den andra håller sitt löfte. Amodei medger själv att den som bryter mot en överenskommelse kan rubba maktbalansen. Just den risken gör att parterna inte vågar lita på varandra.
Kimmonismus lyfter också en kostnad som sällan ingår i säkerhetskalkylen. Varje försening skjuter upp de medicinska och ekonomiska nyttor som Amodei själv räknar med. Han bedömer att AI kan bota stora sjukdomar inom fem till tio år. Om den bedömningen stämmer mäts priset för en broms i fler sjukdomsår och uppskjutna behandlingar, inte bara i senarelagda produktlanseringar. Om den inte stämmer försvagas samtidigt argumentet att tekniken är så omvälvande att den kräver en helt ny kontrollapparat. Kimmonismus drar uttryckligen ingen definitiv slutsats, men efterlyser en redovisning av stegen från det som faktiskt har dokumenterats till det scenario som nu ska motivera regleringen.
Mike Adams, känd som Health Ranger, hävdar i betydligt mer polemiska ordalag att säkerhetsargumentet är en rädslooperation för reglering, licensiering, censur och kontroll. Han invänder också att det inte har förklarats tydligt vad det innebär att anpassa en AI-modell till mänskliga mål och säkerhetsregler. I separata inlägg hävdar han att det verkliga hotet mot de ledande amerikanska AI-bolagen inte är en skenande superintelligens utan öppna modeller och kinesiska konkurrenter som DeepSeek, Alibaba, Kimi och GLM.
Hans andra argument går lättare att pröva. Ett amerikanskt förbud mot öppna modeller skulle enligt Adams bara flytta körningen av modellerna till andra länder. Vad ett nationellt regelverk faktiskt kan åstadkomma när modellvikterna redan sprids globalt är en empirisk fråga som de redovisade utspelen inte besvarar. NyD har i flera senare teknikartiklar följt samma konkurrenstryck. Tidningen har ställt OpenAI GPT-5.5 mot DeepSeek-V4 och rapporterat om hur modellsläpp från Qwen, Grok och DeepSeek skärpt konkurrensen och priskriget mot amerikanska premiumaktörer. Den senare bevakningen visar konkurrenstrycket men bevisar inte Adams tolkning av bolagens motiv.
Vad en legitim reglering måste klara
Teknikjournalisten Brian Merchant gör en närliggande iakttagelse från ett annat håll. Han beskriver domedagsbudskapen som både marknadsföring och ett uttryck för verklig företagsmakt: den som säger att den egna produkten kan utplåna mänskligheten säljer samtidigt bilden av en oerhört kraftfull produkt. Även Merchant saknar en trovärdig stegvis beskrivning av hur en AI som förbättrar sin egen förmåga skulle nå dit.
Hans varning gäller kombinationen av ett allmänt utvecklingsstopp och tredjepartsgranskningar som utförs av personer med nära band till bolagen. Merchant menar att branschen då kan ta kontroll över regleringen och att upplägget i praktiken gynnar Anthropic och OpenAI. Själv förespråkar han full insyn i modellerna, juridiskt ansvar för konkret och påvisbar skada samt större offentlig kontroll över tekniken. Han avfärdar inte AI-relaterade skador. Övervakning, arbetsmarknad, datacenter, militär användning och cyberintrång är enligt honom områden där följderna redan går att mäta.
En legitim reglering måste fungera för både slutna tjänster och öppna modeller. Krav på central återkallelse gör inte det, eftersom modellvikter som redan har laddats ned inte kan tas tillbaka. Ansvar bör bygga på konkret och påvisbar skada. Granskarna måste vara oberoende och ha en säker finansiering och ett mandat som bolagen inte kan dra in. Både testerna och resultaten bör vara offentliga. Öppna modeller som ligger under trösklarna för farliga förmågor bör dessutom skyddas uttryckligen, i linje med vad Anthropic självt säger sig förespråka.
Delar av detta finns redan i förslagen som lades fram under lördagen. Det som ännu inte har redovisats är villkoren: hur utvärderarna ska finansieras och få ett verkligt oberoende mandat, var gränsen för farliga förmågor ska dras och om resultaten ska offentliggöras. Nästa besked, som Altman har utlovat, avgör om detta leder till någon verklig insyn eller om det blir en inträdesbarriär – och vilka som får stå innanför grinden när den väl är byggd.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
OpenAI uppger att AI-agenter har visat hur ett idealiserat vätskeflöde kan utveckla en singularitet trots ändlig energi och en slät yttre kraft. Bilden är en illustration, inte en simulering av beviset.
OpenAI uppger sig ha löst ett av matematikens sju millennieproblem. Enligt bolaget visade omkring 10 000 samtidiga AI-agenter under 88 timmar att lösningarna till Navier–Stokes ekvationer kan bryta samman i ändlig tid – ett arbete som drevs av en intern modell som bolaget beskriver som betydligt kraftfullare än den nyligen släppta GPT-6 Astra.
Bolaget redovisar både en analytisk bevistext och en formalisering i beviskontrollspråket Lean. Enligt redovisningen fastställer resultatet alternativ C – och även D – i Clay-institutets officiella formulering av problemet: sammanbrott för släta lösningar dels i hela rummet, dels i en modell där rummet upprepar sig periodiskt i alla riktningar. Båda alternativen är giltiga vägar till problemets lösning. Den som visar att ekvationerna kan haverera har svarat på frågan lika mycket som den som visar att de aldrig gör det.
Navier–Stokes ekvationer är Newtons andra lag skriven för vätskor och gaser, och de behandlar strömningen som ett sammanhängande medium i stället för att följa varje molekyl. De används för flygplansvingar, väderprognoser och blodflöde. Den öppna frågan i nittio år har varit om denna beskrivning kan bryta samman: kan hastigheterna växa över alla gränser under ändlig tid, trots att viskositeten hela tiden vill jämna ut rörelsen?
Svaret i OpenAI:s bevis är ja. Konstruktionen är en virvel som spiralar inåt och samtidigt sträcks ut som spagetti. Den centrala delen krymper och snabbas upp, men energin i vätskan förblir ändlig. Den yttre kraft som verkar på vätskan beskrivs som slät, det vill säga en kraft som varierar mjukt och jämnt utan hopp eller oändliga toppar – ingen oändlig kraft har alltså lagts in för hand. Termerna för acceleration, tryckgradient, rörelsemängd och viskositet måste enligt bolaget bli mycket stora och ändå ta ut varandra med hög precision.
Annons:
We’re sharing a solution to the Navier-Stokes Millennium Prize Problem, one of the deepest problems at the frontier of mathematics.
Det som avgörs är en matematisk fråga om ekvationernas giltighet, inte turbulensen som fysikaliskt fenomen. Om en singularitet kan uppstå betyder det att just den matematiska beskrivningen slutar gälla i den punkten. Beviset gäller alltså en matematisk modell av strömmande vätskor och gaser – det säger inte hur man löser praktiska turbulensproblem i vingprofiler, väderprognoser eller blodflöde.
Vägen dit gick via ett enklare problem. Bolaget uppger att man sedan den 28 augusti tränar en ny intern modell, och att arbetet mot millennieproblemen startade den 1 september efter rykten om att två av dem lösts. Skilda grupper av agenter fick olika varianter av problemformuleringen: A och B, som skulle ge ett bevis, C och D, som skulle ge ett motbevis. Först föll Euler-ekvationerna, gränsfallet utan viskositet, där knappt hundra agenter under cirka 50 timmar motbevisade regularitet i den version där ingen yttre kraft alls verkar på vätskan. Därefter riktades resurserna mot Navier–Stokes.
Lösningen kom lördagen den 5 september, 88 timmar efter start. Formaliseringen och verifieringen i Lean tog enligt bolaget ytterligare 17 timmar med GPT-6 Astra. Bara för Navier–Stokes skickade agenterna 2,7 miljoner meddelanden och förbrukade omkring 130 miljarder utdata-tokens – ett mått på hur mycket text systemet producerade under arbetet.
Människan i styrhytten
Bolagets egen beskrivning gör inte gällande att modellen löste problemet på egen hand. Forskarna valde problemvarianter, matade den framgångsrika gruppen med Euler-resultatet, bytte till en nyare modellversion under arbetet och lät kodverktyget Codex sammanställa de mest användbara insikterna mellan grupperna. Den grupp som fann lösningen styrdes på det sättet.
Parallellt hade matematikprofessorn Tristan Buckmaster vid NYU och Levent Alpöge, anställd på Anthropic, drivit ett eget program vidare från Diego Córdoba och Luis Martínez-Zoroa och nått sammanbrott med slät yttre kraft för porösa medier, Boussinesq och tredimensionell Euler. I ett publicerat uttalande beskriver Buckmaster hur han under samtal med OpenAI den 6 september fick höra att ett internt system löst Navier–Stokes med yttre kraft, och hur han erbjöds att själv skriva en artikel om resultatet. Enligt hans redogörelse uppgav OpenAI-forskaren Sebastien Bubeck två gånger att Alpöge borde tas bort från författarskapet. Buckmaster tackade nej och betonar samtidigt att han inte sett beviset och inte anklagar någon för något.
OpenAI säger att man erbjöd samtidig publicering och insyn i sina prompter, erkänner de bådas prioritet på Euler med yttre kraft och uppger att varken forskare eller agenter sett deras arbete före det publika släppet. Ingen specifik användardata ska ha hämtats. Bolaget skriver samtidigt att det inte kan utesluta att avidentifierad data från de bådas användning av produkterna bidragit till att förbättra modellerna. Bubeck avvisade vid en pressträff att företaget använt deras arbete.
Lean-filerna ligger publikt på Github, och enligt OpenAI är beviskedjan därmed maskinellt verifierad. Det är inte samma sak som att matematikersamfundet godkänt resultatet. Clay-institutets regler kräver publicering i en godkänd vetenskaplig publiceringskanal, minst två års väntan och allmän acceptans i den globala matematikvärlden – och institutet tar inte emot direkta inlämningar. OpenAI uppger att man inte avser att göra anspråk på miljonprisbeloppet.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Kinesiska DeepSeek släppte under torsdagen sin nya billigmodell V4.1-Flash – och enligt bolagets egna tester går den före flera av världens tyngsta AI-modeller. Samtidigt sänks priset igen för de utvecklare som bygger in modellen i sina egna tjänster.
Det första en användare märker är att modellen ser. V4.1-Flash tar emot både bilder och text och svarar med text. Den kan alltså läsa av ett kvitto, ett diagram eller en skärmdump direkt, utan att en separat bildmodell kopplas in i kedjan.
Mer uppseendeväckande är testresultaten. DeepSeek redovisar en rad prov där modellen inte bara ska svara på en fråga, utan själv arbeta sig igenom ett uppdrag i flera steg: leta i filer, köra kommandon och rätta sina egna misstag. Det är det arbete som AI-bolagen nu säljer som "agenter". På provet Terminal-Bench 2.1 får V4.1-Flash 90,6 poäng, mot 89,1 för Anthropics Opus-5.0 och 88,8 för GPT-5.6 Sol.
På AutomationBench, som mäter hur väl en modell klarar att automatisera arbetsuppgifter, blir skillnaden större: 54,8 poäng mot 50,3 för Opus-5.0 och 45,8 för GPT-5.6 Sol. Att modellen, som bolaget kallar den minsta i sin nya arkitekturfamilj, går före flaggskeppen är hela poängen med släppet.
Annons:
🧠 Asymmetric architecture. More intelligence, less cost.
🔹 552B-parameter MoE. 🔹 New Causal Encoder–Decoder architecture: just 8B active parameters for input, 16B for output. 🔹 New pre-training methods + larger-scale RL post-training deliver benchmark results ahead of… pic.twitter.com/1z37Acfq26
Siffrorna kommer från DeepSeek själv och är uppmätta med modellens resonemangsinställning i högsta läge, alltså den dyraste konfigurationen. Något generellt övertag är det inte heller: på det svårare Terminal-Bench 4.0 stannar V4.1-Flash på 31,2 poäng mot 51,8 för Opus-5.0.
För många köpare är det ändå prislappen som avgör. En miljon inmatade tokens kostar 0,15 dollar under lågtrafik och en miljon tokens i svar 0,60 dollar, enligt vad bolaget redovisar. En token är den minsta textbit modellen räknar i – ett kort ord, en orddel eller ett skiljetecken. Det handlar om listpriset i utvecklartjänsten, där andra företag kopplar in modellen i sina egna produkter, inte om priset på ett chattabonnemang.
Bakom sänkningen ligger konstruktionen. Modellen aktiverar bara en liten del av sig själv för varje textbit som läses in och skrivs ut, och minnet för pågående samtal har krympt kraftigt jämfört med föregångaren. Den färdiga modellen går dessutom att ladda ner och köra på egen hårdvara under MIT-licens.
Bolaget litar tillräckligt på nykomlingen för att låta den ersätta sin egen toppmodell: från den 14 september besvaras anrop till V4-Pro av V4.1-Flash, till Flash-pris, i väntan på en kommande V4.1-Pro.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Kinesiska DeepSeek planerar att installera minst 160 000 av Huaweis kommande AI-chipp Ascend 950DT i ett nytt datacenter i Inre Mongoliet, enligt uppgifter till Bloomberg. Satsningen skulle skapa ett av de största kända klustren med kinesiska AI-processorer och bli ett konkret steg bort från beroendet av amerikanska Nvidia.
Chipsen ska användas för att köra DeepSeeks modeller och hantera frågor från användare – den del av AI-processen som kallas inferens. Däremot har bolaget enligt uppgifterna inga planer på att använda dem för den betydligt mer krävande träningen av modellerna, där DeepSeek hittills har fortsatt att förlita sig på Nvidia.
The Decoder återger Bloombergs uppgift att tidsplanen beror på Huaweis förmåga att tillverka de nya processorerna. Varken DeepSeek eller Huawei har offentligt bekräftat beställningen, och nyhetsbyråns uppgifter bygger på personer med insyn i planerna.
Huawei-chipp för den dagliga AI-driften
Ascend 950DT är fortfarande en kommande produkt. Enligt Huaweis färdplan ska chippet lanseras under fjärde kvartalet 2026. Det får 144 gigabyte höghastighetsminne, en minnesbandbredd på fyra terabyte per sekund och två terabyte per sekund i bandbredd mellan processorerna.
Annons:
Huawei marknadsför 950DT både för modellträning och för den så kallade avkodningsfasen i inferens, när en färdig modell steg för steg genererar sitt svar. DeepSeeks rapporterade val att tills vidare begränsa chippet till drift visar samtidigt var den kinesiska halvledarindustrin redan kan ersätta Nvidia – och var det amerikanska bolagets hårdvara fortfarande bedöms vara svårare att undvara.
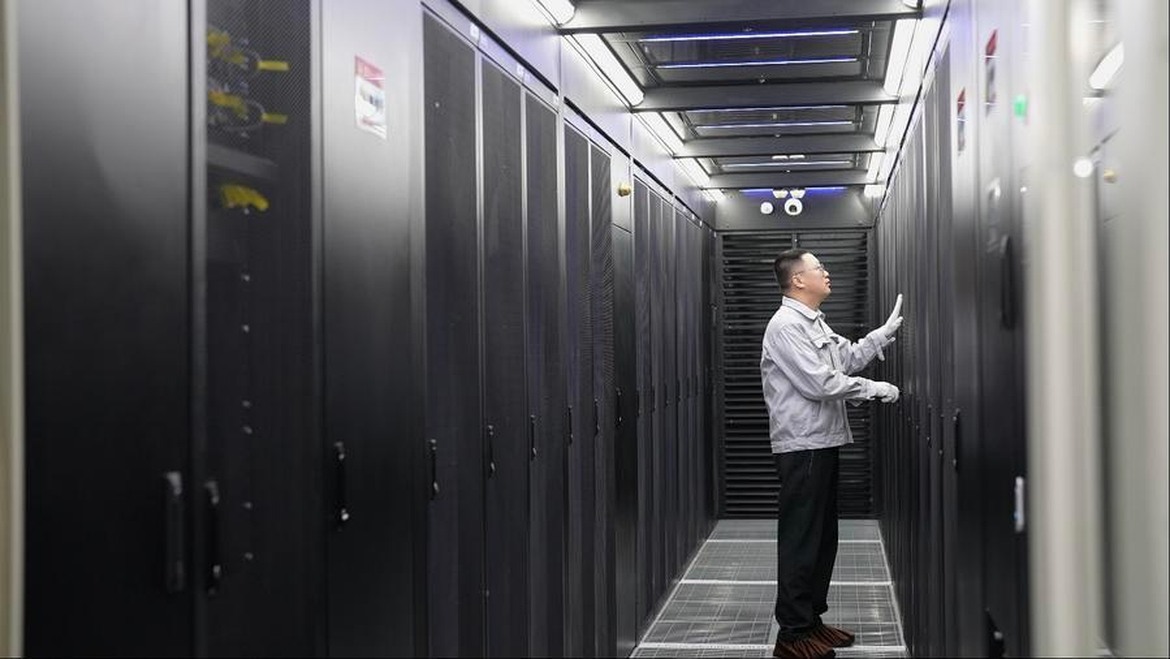
En tekniker inspekterar utrustning i Horingers datacenterkluster i Inre Mongoliet. Foto: Su Yali/Xinhua.
Storleken på beställningen måste också sättas i perspektiv. Huaweis eget Atlas 950 SuperPod är konstruerat för upp till 8 192 Ascend-processorer. DeepSeeks uppgivna volym motsvarar chipmängden i närmare 20 sådana fullskaliga system, även om den slutliga arkitekturen för datacentret inte är känd.
Ett datacenter i gigawattklass
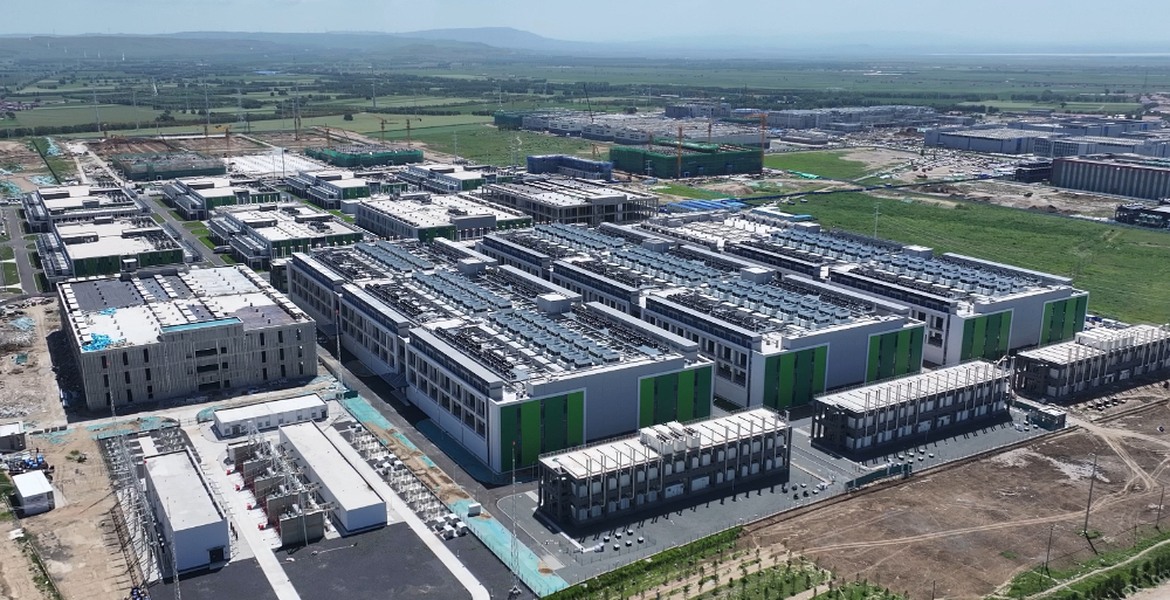
Planerna på själva anläggningen blev kända i slutet av juli. Financial Post återgav då Bloombergs uppgift att DeepSeek vill bygga ett eget datacenter med omkring en gigawatts effektkapacitet i Ulanqab, cirka 35 mil nordväst om Peking, och samtidigt hyra ytterligare beräkningskapacitet från andra aktörer.
Enligt samma rapportering kunde delar av anläggningen tas i bruk mot slutet av 2027 eller början av 2028. En sådan tidsplan förutsätter dock att Huawei kan leverera processorerna i den takt som projektet kräver.
Ulanqab har på kort tid blivit ett av Kinas viktigaste områden för datacenter. Staden ligger i landets nationella satsning ”Östlig data, västlig beräkning”, där energikrävande serverkapacitet flyttas närmare billigare elproduktion i de västra delarna av landet.
Kyla och grön el lockar
Inre Mongoliet har stora tillgångar på vind- och solkraft, gott om mark och ett klimat som minskar behovet av mekanisk kylning. Årsmedeltemperaturen i Ulanqab är omkring 4,3 grader, och datacenter kan använda utomhusluft för kylning under ungefär tio månader om året. Under jämförbara tekniska förhållanden kan det enligt Xinhua minska kylenergin med 20 till 30 procent.
Regionens operativa beräkningskapacitet uppgick i augusti till 345 000 petaflops, varav 326 000 petaflops avsåg AI-beräkningar. Mer än 85 procent av elen till datacentren kom enligt Xinhua från förnybara källor.
Bara i Ulanqab hade den operativa kapaciteten nått 172 000 petaflops, med AI som mer än 95 procent av totalen. Huawei, Alibaba, Apple och flera kinesiska telekombolag har redan etablerat stora anläggningar i området.
Planerna har varit omstridda
Hur långt DeepSeek faktiskt har kommit är ännu oklart. Den 8 augusti rapporterade China Daily, med hänvisning till egna källor, att bolaget hade diskuterat samarbete med lokala myndigheter men att parterna då inte hade förbundit sig till ett datacenter i gigawattklass. DeepSeek uppgavs i stället använda en begränsad mängd hyrd kapacitet från lokala leverantörer.
Samma artikel beskrev samtidigt hur energibolaget Envision redan färdigställt en anläggning på 120 000 kvadratmeter i Ulanqab, avsedd att kunna köra upp till en miljon AI-chipp parallellt. Staden hade då lockat 89 datacenterprojekt. Den infrastrukturen gör platsen logisk även för DeepSeek, men dagens nya uppgifter är fortfarande inte en offentlig bygg- eller inköpsbekräftelse.
Kinas AI-kapplöpning flyttar in i serverhallen
DeepSeek fick sitt internationella genombrott genom modeller som kunde mäta sig med amerikanska konkurrenter trots betydligt mindre rapporterade resurser. En beställning på 160 000 processorer visar en annan sida av utvecklingen: även effektivare modeller kräver enorm fysisk infrastruktur när de ska användas av miljontals människor.
För Huawei skulle affären bli ett skyltfönster för företagets strategi att kompensera för Kinas svagare tillgång till avancerad chiptillverkning genom att koppla samman mycket stora mängder egna processorer. Företaget planerar ett Atlas 950 SuperCluster med mer än 520 000 Ascend 950DT-chipp och över 10 000 serverskåp.
För DeepSeek blir den avgörande frågan om Huawei kan leverera i tid och om den kinesiska mjukvaran kan utnyttja klustret tillräckligt effektivt. Om projektet genomförs som rapporterat får Kina inte bara ännu ett stort datacenter, utan en av de tydligaste demonstrationerna hittills av att landets AI-industri kan börja flytta den dagliga driften från Nvidia till inhemsk hårdvara.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.