En uppmärksammad fuskhärva vid Brown University i USA väcker nya frågor om hur universiteten ska hantera generativ AI. Efter misstankar om ChatGPT-fusk gjorde en ekonomiprofessor om slutprovet till en salstenta – varpå snittresultatet halverades.
Fallet gäller Roberto Serrano, professor i nationalekonomi vid Brown University, och kursen ECON 1170 i matematisk ekonomi. Enligt Ars Technica valde Serrano under vårterminen 2026 att tillåta hemtentor sedan en skjutning på campus i december hade skapat oro bland studenterna.
Kursen hade tidigare normalt haft färre än 30 studenter. När hemtentor infördes steg antalet deltagare till 86. Resultaten på delprovet blev samtidigt anmärkningsvärt höga: snittet landade på 96 av 100 poäng och 40 studenter fick full pott.
Serrano uppgav för Inside Higher Ed att provet dessutom var svårare än tidigare år, eftersom studenterna hade obegränsad tid. Han reagerade också på att flera svar hade en omständlig och onaturlig stil. När han och hans doktorander matade in frågorna i ChatGPT fick de enligt honom svar som påminde om studenternas.
Annons:
Flyttade slutprovet till sal
Professorn informerade därefter klassen om att slutprovet skulle hållas i sal. Om resultatfördelningen låg i nivå med delprovet skulle båda proven räknas, men om resultaten skilde sig kraftigt skulle delprovet ogiltigförklaras och slutprovet väga tyngre.
Efter beskedet hoppade 18 studenter av kursen, medan ytterligare nio inte dök upp till slutprovet. Enligt El País hade 22 av dessa 27 studenter fått full pott på delprovet.
Bland dem som skrev slutprovet föll snittresultatet från 96 till 48 procent. Serrano beskriver händelsen som ett tecken på en djupare akademisk kris.
— Vi har inte råd med ett samhälle där en betydande del av våra bästa unga hjärnor tycker att fusk är okej, säger han till Inside Higher Ed.
Studenter oroas för den egna inlärningen
Brown University publicerade nyligen en rapport om generativ AI i undervisning och lärande. I rapporten uppgav 56 procent av studenterna på grundnivå och 67 procent av doktorand- och läkarstudenterna att de medvetet använder generativa AI-verktyg dagligen eller varje vecka.
Samtidigt visar rapporten att många studenter oroar sig för hur AI-användningen påverkar deras lärande och förmåga att tänka självständigt.
En undersökning vid Princeton, som Ars Technica tidigare rapporterat om, pekade också på att nästan 30 procent av de svarande studenterna medgav att de använt AI för att fuska på minst ett prov eller en inlämning.
Brown-fallet har därför blivit en symbol för den konflikt som nu växer inom högre utbildning: hur AI kan användas som hjälpmedel utan att samtidigt urholka examination, kunskapsinhämtning och akademisk integritet.
Läsaromröstning
Vilken åtgärd tycker du är mest rimlig för att hantera AI-fusk vid universitet?
Röstning stängd
Återgå till salstentor och övervakade prov80%
28 röster
Införa AI-detektorer och striktare regler0%
0 röster
Acceptera AI som ett verktyg och anpassa examinationen0%
0 röster
Kombinera olika metoder som muntliga prov och projektarbeten20%
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
AI-bolaget Anthropic hävdar att dess språkmodell Claude, med bara övergripande instruktioner från bolagets forskare, har hittat ett tidigare obeskrivet enzymsystem i bakterievirus. Bredvid enzymgenen ligger en lång rad DNA-upprepningar som påminner om CRISPR. Vad systemet faktiskt gör vet ingen ännu, inte heller bolaget.
Anthropic skriver i ett tillkännagivande den 23 september att systemet har fått namnet ART, efter engelskans array-associated reverse transcriptases. Fyndet presenteras som det första publika resultatet från en ny forskargrupp inom biovetenskap, som bolaget har byggt ett eget molekylärbiologiskt labb för i Bay Area i Kalifornien.
Det handlar inte om något nytt gensaxverktyg. Anthropic medger själv att systemets funktion är okänd och att experimenten fortsätter. Bolagets förhoppningar vilar på att ART har en kombination av egenskaper som hittills bara har hittats i en handfull andra system. Alla dessa är programmerbara och kan klippa, kopiera eller klistra in DNA.
950 agenter på 21 timmar
Enligt bolaget var forskarnas insats begränsad till den inledande instruktionen och labbarbetet. Claude fick i uppdrag att söka igenom en stor databas med DNA-sekvenser efter intressanta nya exempel på omvända transkriptaser, förkortat RT. Det är enzymer som kopierar RNA till DNA.
Annons:
Därefter tog modellen över. Omkring 950 Claude-agenter arbetade i 21 timmar och förbrukade 210 miljoner tokens, alltså de textenheter som språkmodeller räknar i. Agenterna samlade in över 200 000 RT, pekade ut 3 500 nya kandidatsystem och sållade fram de 20 mest lovande. För varje kandidat skrevs en rapport som människor kunde läsa och granska.
Anthropic uppger att den här typen av genomgång kan ta veckor till månader för en erfaren forskare.
Under sökningen fastnade en av agenterna för en ovanlig RT-familj. I den råa DNA-sekvensen intill genen såg den ett upprepat mönster. Enligt bolagets återgivning kallade agenten sekvensen "spektakulär" och undrade om den kunde vara en CRISPR-liknande upprepningsrad.
RT-enzymet i den så kallade jumbo-fagen var redan känt från tidigare studier. Det Anthropic tillskriver Claude är att modellen kopplade enzymet till den intilliggande raden av DNA-upprepningar och en gen för ytterligare ett protein, vars funktion inte är känd. Tillsammans utgör de tre delarna det system bolaget kallar ART.
Korta RNA – men okänd funktion
I de första laboratorieförsöken uttrycktes upprepningsraden som flera skilda, korta RNA, enligt Anthropic. Det är ett tidigt fynd som gör liknelsen med CRISPR intressant, men det visar inte vad ART gör eller att systemet kan användas för genredigering.
CRISPR-pionjären Feng Zhang, professor vid MIT och Broad Institute, har läst forskarnas preprint. I ett uttalande som Anthropic återger kallar han fyndet av RNA-upprepningsrader kopplade till omvända transkriptaser verkligt intressant och värt att undersöka vidare. Han beskriver arbetet som ett spännande exempel på hur AI-agenter kan bidra till biologiska upptäckter och hoppas att fler forskare utforskar hur AI kan stödja deras forskning.
Det praktiska labbarbetet utförs av människor, uppger bolaget. Anthropic beskriver verksamheten som forskning på säkerhetsnivåerna BSL-1 och BSL-2 och säger att labbet inte hanterar patogener som kan infektera människor.
Forskarna redovisar fynden i en preprint. Nästa steg är experiment som kan visa hur ART fungerar. Än så länge har AI-agenterna pekat ut ett möjligt nytt system – inte klarlagt vad det gör.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Anthropic och OpenAI tog på tisdagskvällen varsitt stort kliv, med drygt en timmes mellanrum. Claude Opus 5.5 slår bolagets eget flaggskepp på flera av de tester Anthropic själv redovisar, och kostar samtidigt mindre att köra än föregångaren. OpenAI svarade med GPT-6 Sol och GPT-6 Luna: två modeller som dumpar priset och för ner mycket av flaggskeppet GPT-6 Astras förmåga i ett snabbare och billigare format. Det är inte två sidospår. Det är fronten som flyttas samma kväll, från två håll.
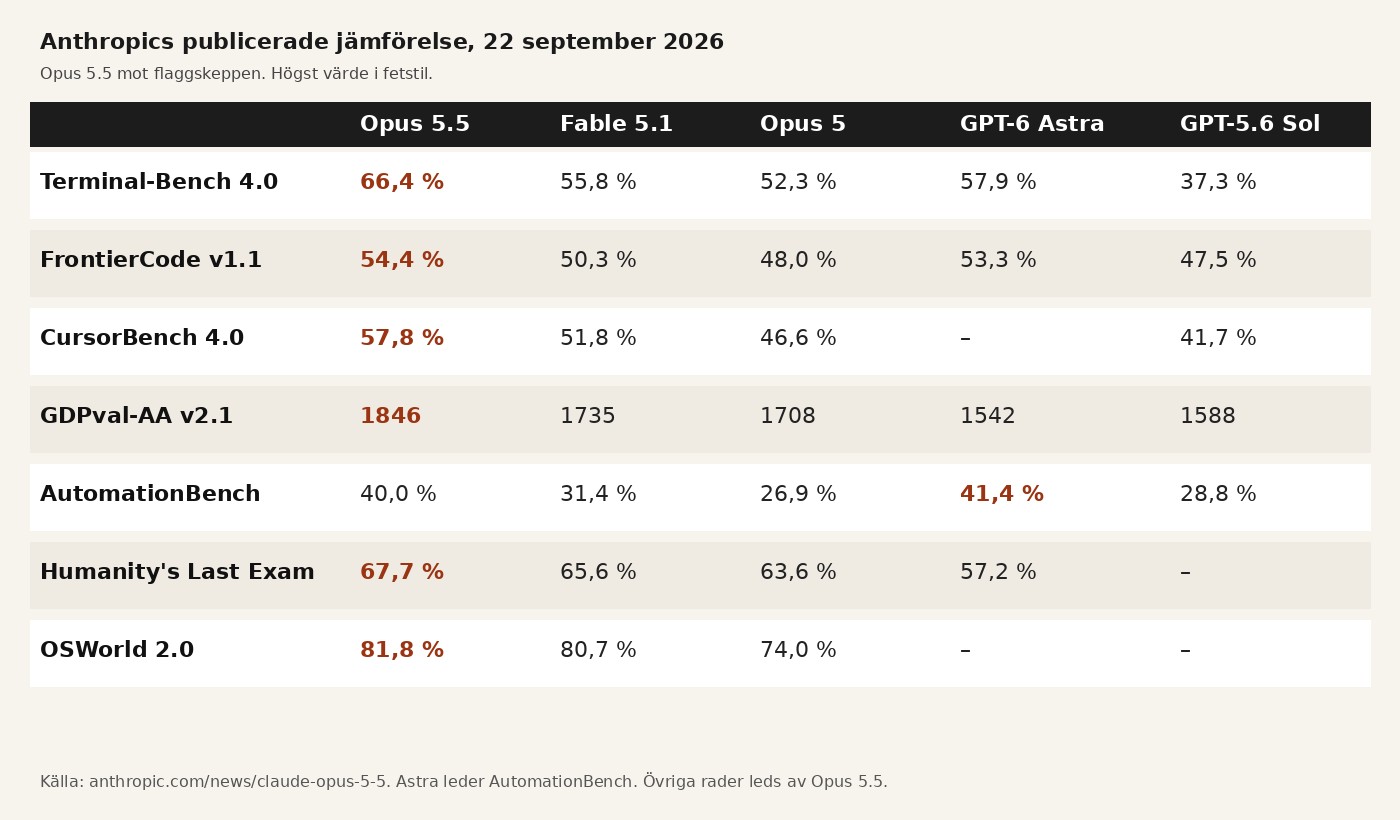
Anthropic gick först. Klockan 18.31 svensk tid publicerade bolaget Claude Opus 5.5, den första modellen i Claude 5.5-familjen. I de egna tabellerna leder den kodning med agenter, datoranvändning och kunskapsarbete. På Terminal-Bench 4.0, ett test av verkliga kommandoradsuppgifter, når den 66,4 procent vid hög ansträngning, mot 55,8 för flaggskeppet Claude Fable 5.1 och 57,9 för GPT-6 Astra. På GDPval-AA v2.1, ett test av arbete i 44 yrken, får den 1846 poäng mot Astras 1542.
Klockan 20.12 presenterade OpenAI GPT-6 Sol och GPT-6 Luna. Bolaget beskriver dem som snabbare och billigare modeller, tränade med liknande metoder som Astra, som ska bära framstegen bakom flaggskeppet vidare till arbete i skala. Sam Altman kommenterade släppet positivt. Priset är vapnet: Sol kostar 2 dollar per miljon token i input och 10 dollar i output. Luna kostar 0,10 respektive 0,50 dollar.
Anthropic skriver samtidigt att Opus 5.5 på de flesta uppgifter ligger i nivå med Fable 5.1, och att gapet i bolagets egen användning är smalare än tabellerna antyder. Det tar inte bort klivet. Modellen kostar 40 procent mindre att köra än Claude Opus 5, och utdata ska komma mer än 30 procent snabbare vid standardinställning. OpenAI räknar sin halvering mot kampanjpriserna för GPT-5.6, inte mot ordinarie listpriser, och lovar dessutom 90 procents rabatt på cachade input-token.
Annons:
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family.
It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5. pic.twitter.com/Q9C2VKQ79f
Please welcome GPT-6 Sol and GPT-6 Luna to the GPT-6 universe.
GPT-6 Sol and Luna build on the advances behind GPT-6 Astra, bringing much of its strengths into faster and more affordable models to support work at scale.
Opus 5.5 slår Fable 5.1 på de tester Anthropic lyfter fram. Astra leder ett av dem. Källa: Anthropic.
Säljargumentet är alltså inte bara pris. Anthropic redovisar att Opus 5.5 vid standardinställning slår GPT-6 Astra på maxansträngning i kunskapsarbetet, till ungefär en femtedel av kostnaden per uppgift. Samma tabell visar att Astra fortfarande ligger före på AutomationBench, 41,4 procent mot 40,0. Bolaget skriver själv att benchmarkmarginaler blivit en sämre guide till skillnaden i verkligt bruk. Det är ett ovanligt medgivande i ett lanseringsdokument som ändå är fullt av marginaler.
OpenAI har valt andra motståndare. Sol ställs mot Claude Opus 5 och mot Fable 5 och 5.1, inte mot Opus 5.5, som släpptes samma kväll. På AutomationBench, Zapiers test av affärsflöden med 47 verktyg, når Sol 33,2 procent vid högsta ansträngning till 0,27 dollar per uppgift. OpenAI säger att det slår Opus 5 vid maximal ansträngning, som får 26,9 procent, till 9 procent av kostnaden. Fable 5.1 med Opus 5 som reserv når 31,4 procent i samma jämförelse. OpenAI anger att reserven användes på omkring 40 procent av uppgifterna och att dess kostnad inte är inräknad.
På DeepSWE v1.1 hamnar Sol på 68,8 procent, 1,1 procentenheter under Fable 5, till omkring 80 procent lägre kostnad per uppgift. Luna når 66,6 procent, vilket OpenAI jämför med Opus 5 och Fable 5 vid medelnivå. Vid högre ansträngning ska Luna matcha GPT-5.6 Sol till ungefär en hundradel av kostnaden.
Tidiga testare som Anthropic lyfter fram pekar åt samma håll. En ska ha slutfört en kodmigrering på 680 000 rader på mindre än en dag. En annan lät Opus 5.5 granska och rätta en kodbas på 200 000 rader på under tre timmar, där Opus 5 behövde över 20 timmar och 2,5 gånger så många token. I ett internt test översatte Opus 5.5 och Fable 5.1 lastbalanseraren HAProxy från C till Rust. Båda klarade nästan alla regressionstester, men Opus 5.5 blev klar på 9,5 timmar mot 12 och kostade 51 procent mindre.
GitHubs produktchef Mario Rodriguez citeras av Anthropic med att utvecklare vill ha agenter som kan ta sig an verkligt programmeringsarbete och slutföra det. Enligt GitHub använde Opus 5.5 bland de lägsta mängderna token och steg i tester i Copilot CLI och VS Code. Utanför bolagens egna papper visade kontot BridgeMind på X hur modellen i ett enda försök byggde ett spelbart Mario Kart-liknande spel, med figurer som Mario och Luigi. Kontot uppger att resultatet är tydligt bättre än Fable 5.1, som enligt dem inte fått fram spelbara figurer på samma sätt. Det är en demonstration, inte ett officiellt test.
Claude Opus 5.5 just ONE SHOT a Mario Kart game.
The result is way better than Fable 5.1. The attention to detail is on another level.
Opus 5.5 actually created real characters. Mario, Luigi, in the game, playable. Fable 5.1 has never done that.
Opus 5.5 kostar 4 dollar per miljon token input och 20 dollar output, mot 5 och 25 dollar för Opus 5. Cachade läsningar sjunker från 0,50 till 0,20 dollar. Ett snabbare läge, upp till 2,5 gånger snabbare, kostar 8 dollar input och 40 dollar output. Anthropic räknar med att typiska arbetsflöden vid standardinställning blir 40 procent billigare.
På OpenAI:s sida är fallet brantare. GPT-6 Sol på 2 och 10 dollar, och GPT-6 Luna på 0,10 och 0,50, är inte sidomodeller i marginalen. Luna är den modell som gör skalan möjlig: samma familj som Astra, till en kostnad som i bolagets egen jämförelse kan ligga kring en hundradel av GPT-5.6 Sol. Halveringen för Sol räknas, som sagt, mot kampanjpris. Även med det förbehållet är riktningen entydig. Köparna får mer av flaggskeppets arbetssätt för mindre pengar, samma kväll som Anthropic kapar priset på sin nästa Opus.
Astra står kvar som OpenAI:s mest intelligenta modell, och den bästa över lag enligt bolaget självt. På datoranvändning är den fortfarande bäst i OpenAI:s egen redovisning. Sol och Luna rullas ut för att arbetet ska kunna köras i volym, inte för att Astra ska pensioneras. Det är just därför släppet är stort: fronten blir inte en modell som få har råd att anropa.
Spärrarna sitter kvar
Opus 5.5 är Anthropics första släpp sedan vd Dario Amodei uppmanade branschen att bromsa fronten. Bolaget uppger att modellen testats före släpp av externa utvärderare, bland andra Frontier Design och METR, och att den fått sitt starkaste resultat hittills i Anthropics mest omfattande beteendetest, en automatiserad genomgång av hur modellen agerar. Den får säkerhetsspärrar liknande Fable 5.1, enligt bolagets systemkort, eftersom Anthropic bedömer den som jämförbar med Claude Mythos 5.1 inom biologi och cybersäkerhet. Tänkläget går inte att stänga av.
OpenAI säger att Sol och Luna ligger bättre till än GPT-5.6 i bolagets säkerhetstester, bland annat med färre vilseledande påståenden om sitt eget kodarbete. I ett internt test på samtal där användare flaggat faktafel gör Sol enligt bolaget ungefär hälften så många fel som föregångaren.
Tillgången skiljer sig. Opus 5.5 finns på Claude-plattformen och hos AWS, Google Cloud och Microsoft Azure, med en kontext på 1 miljon token och kunskapsavbrott i juni 2026. Tidsgränserna höjs för Pro, Max, Team och platsbaserade Enterprise. GPT-6 Sol och Luna rullas ut gradvis i ChatGPT Work och Codex för Plus, Pro, Business, Enterprise och Edu, men ännu inte i Chat. Användare av Free och Go kan köra Luna i skrivbordsappen.
Nästa drag är redan aviserat. Anthropic lovar Sonnet 5.5 och Haiku 5.5 de närmaste veckorna. Den jämförelse köparna fortfarande saknar, ett gemensamt test av Opus 5.5 mot GPT-6 Sol, finns inte i något av bolagens material. Det som finns är två officiella släpp, två prissänkningar och en kväll där båda vägrade lämna fronten åt den andra.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
AI-bolaget SpaceXAI (tidigare xAI) släppte under måndagen Grok 4.7, som bolaget kallar sin mest kapabla modell för kodning och kunskapsarbete. Den kostar lika mycket och svarar lika snabbt som föregångaren Grok 4.6, finns direkt i Cursor, Grok Build och Grok API – och alla siffror som ska visa förbättringen kommer från bolaget självt.
Det konkreta i släppet är inte ett nytt prisläge utan ett nytt innehåll bakom samma prislapp. Enligt bolaget bygger Grok 4.7 på en ny och större basmodell än 4.6, har tränats med en längre förstärkningsinlärningsomgång på en svårare uppgiftsmix med tyngdpunkt på problem som tar många timmar, och har blivit bättre på att kontrollera sitt eget arbete och hantera långa kontexter. Modellen är också tränad att förstå bolagets egen agentmiljö, Grok Bot-harnesset, direkt.
I API:et heter modellen grok-4.7 och kostar 2 dollar per miljon inmatade tokens och 6 dollar per miljon utmatade – exakt samma nivå som Grok 4.6 High. Kontextfönstret ligger på 500 000 tokens och kunskapsbrytningen är maj 2026. Den som vill ha mer fart kan välja en snabbvariant med dubbel utdatahastighet till dubbla priset.
Bolaget redovisar en tabell med sju mätserier. Tre av dem är tydliga steg framåt. På EEBench får Grok 4.7 resultatet 64,0 mot 53,0 för 4.6. På Harvey Legal Agent, som mäter juridiskt agentarbete, redovisas 19,6 mot 15,8 för föregångaren och 2,5 respektive 6,7 för de två konkurrentmodeller bolaget jämför med. Mest dramatisk är skillnaden på Terminal-Bench 4.0, där 4.7 landar på 38,0 mot 4.6:s 20,3 – nästan en fördubbling på ett halvår.
Annons:
Men tabellen visar också var modellen inte leder. På samma Terminal-Bench 4.0 ligger konkurrenten Fable 5.1 på 57,9, alltså långt över Grok 4.7. På CursorBench 4.0 får Grok 4.7 46,3 mot Fables 51,8, och på HealthBench Professional 56,7 mot 62,1. I bolagets egen Elo-mätning på GDPval hamnar Grok 4.7 xHigh på 1 695 – över Grok 4.6 High på 1 605 och GPT-6 Astra Max på 1 542, men under Fable 5.1 Max på 1 735.
Bolagets eget säljargument är därför inte topplaceringen utan prisförhållandet: samma resultatnivå för 2 och 6 dollar per miljon tokens, där jämförelsemodellerna i tabellen ligger på 4/20 respektive 10/50 dollar. Inget av resultaten är oberoende verifierat, och samtliga tal i tabellen är uppmätta och publicerade av SpaceXAI självt.
Stadsbyggarspelet som demo
Som konkret exempel visar bolaget hur de två modellversionerna får samma uppgift: att bygga ett öppet stadsbyggarspel. Grok 4.7 visas först, Grok 4.6 därefter. Det är precis den sorts uppgift som den längre träningen sägs vara riktad mot – ett flertimmarsjobb där modellen måste hålla ihop kod, struktur och egna kontroller över lång tid utan att en människa styr varje steg.
Demon är vald av bolaget och säger inget om hur modellen beter sig på en riktig kodbas hos en riktig kund. Men den illustrerar riktningen i hela branschen: konkurrensen har flyttat från snabba svar till agenter som jobbar vidare på egen hand i timmar. Det är där leverantörerna nu pressar varandra, och det är också där felen blir dyra, eftersom en modell som arbetar länge utan tillsyn hinner göra mycket innan någon upptäcker att den var på fel spår.
Säkerhetslagret och de siffror som inte är hundra
SpaceXAI beskriver Grok 4.7 som utrustad med bolagets bäst kalibrerade skyddslager hittills – ett helt nytt så kallat safeguard-stack, som enligt bolaget är starkast på vägran och motstånd mot jailbreak. Två tal anges. På HackerBench v0.3 släpps 3,3 procent av riskabla prompter med dubbel användning igenom. På LatchBios biosäkerhetsmätning redovisas 62,4 procent.
Med andra ord: drygt tre av hundra riskabla förfrågningar passerar ändå, och biosäkerhetsresultatet ligger en bra bit under full träff. Bolaget har dessutom bjudit in utvalda cybersäkerhetspartners till slutna red team-övningar för försvarsforskning. Vilka partnerna är framgår inte, och de publicerade talen är bolagets egna mätningar på bolagets egna testmängder.
Var modellen finns – och vad som händer nu
Tillgängligheten är det som avgör hur snabbt släppet får praktisk betydelse. Grok 4.7 finns från dag ett i Cursor och Grok Build samt i Grok API, och därutöver via tredjeparts kodmiljöer, modellroutrar och molntjänster. Den som redan kör grok-4.6 i produktion byter i praktiken modellnamn utan att röra budgeten.
Takten är värd att notera. I juli släpptes Grok 4.5 med samma prislapp, 2 och 6 dollar per miljon tokens, och samma kontextfönster på 500 000 tokens. Sedan dess har bolaget bytt namn, passerat 4.6 och nu 4.7 – utan att röra priset en enda gång. Prislistan har blivit branschens fasta punkt medan modellerna under den byts ut i månadstakt.
Vad kunden faktiskt får för de oförändrade 2 och 6 dollarna avgörs därför inte av tabellen utan av hur den nya modellen sköter sig i timslånga agentkörningar hos företag som låter den arbeta i egna system. Den prövningen börjar nu, och den görs av andra än bolaget självt.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.
Det kinesiska teknikbolaget Alibaba släppte under söndagen bildmodellen Qwen-Image-2.1 med öppna vikter. Den kan laddas ner kostnadsfritt, köras hemma och verkar vara riktigt bra: på Qwens egen mätning går den om Googles toppmodell Nano Banana 2.0, tidiga testare har redan visat vad den klarar, och NyD:s egen genomkörning ger samma intryck.
Qwen-Image-2.1 är en och samma modell för text-till-bild och bildredigering, och enligt Qwens egen presentation är den byggd för att vara liten nog att köras billigt. Den visuella genereringsdelen rymmer sju miljarder parametrar fördelade på 32 Single-Stream DiT-lager, en kraftig bantning mot den ursprungliga Qwen-Image på 20 miljarder parametrar.
Att gå från 20 till 7 miljarder parametrar är själva poängen för den som vill köra lokalt. En slankare modell tar mindre plats i minnet och kan köras till lägre kostnad, vilket enligt Qwen är skälet till att 2.1 finns. Fler kan hämta vikterna och köra dem på den dator de redan har.
Modellkortet på Hugging Face och kodprojektet på GitHub publicerades samma dag. Stödet i de vanligaste verktygen fanns på plats direkt: Diffusers via QwenImage21Pipeline, ComfyUI, vLLM-Omni, SGLang och LightX2V. För den som redan har en lokal bildkedja igång handlar det om en nedladdning, inte om månader av väntan på tredjepartsstöd.
Annons:
Qwen-Image-2.1 is awesome! fast, native 2K, native transparency, up to 10 reference images, better identity fidelity & improved typography. Here are 2 images generated using it btw https://t.co/pg4Gk1rXJcpic.twitter.com/WEYqFGiqP2
Den mest påtagliga nyheten i själva motorn är att modellen hanterar genomskinlighet direkt, i RGBA. Den kan enligt Qwen både skapa bilder med genomskinliga lager och lyfta ut motiv ur vanliga fotografier, utan att ett separat verktyg behöver klippa runt kanterna i efterhand.
Den förmågan låg tidigare i en egen modell. I december 2025 presenterade teamet Qwen-Image-Layered enbart för genomskinliga bilder. Nu sitter samma funktion i huvudmodellen, vilket kortar vägen från en genererad bild till en användbar grafisk resurs för den som arbetar med logotyper, produktbilder eller montage. Ett extra steg faller bort: genomskinliga lager ligger i samma modell som ritar och redigerar resten.
Redigeringsdelen tar emot upp till tio referensbilder. Qwen visar i sin genomgång hur modellen sätter ihop ett gruppfoto av sex enskilda porträtt, provar kläder på en person utifrån fem indata och möblerar ett rum med tio inredningsreferenser som underlag.
Det är samma slags uppgifter som många annars skickar in i en stängd bildtjänst. Här stannar både referenserna och resultatet hos den som kör modellen.
Lokala ändringar styrs genom att användaren ritar en cirkel i bilden, målar en markering eller skickar med en separat mask. Upplösningen är inbyggd 2K utan uppskalning i efterhand, där 1:1-formatet motsvarar 2048x2048 pixlar.
För den som redan arbetar i ComfyUI eller Diffusers betyder det att en enda modell på sju miljarder parametrar kan både rita nytt och bättra på befintliga bilder. Den som sätter upp kedjan lokalt behöver inte byta verktyg mellan generering och redigering, och resultatet kan komma ut med genomskinlig bakgrund när uppgiften kräver det.
🤯 My RTX 3090 made THESE. I still cant get over it.
Qwen-Image-2.1 running locally is pure magic. I kept making the prompts weirder and it kept giving me stuff I wanted to save.
All generated locally, straight from the model. No upscaling or retouching.
På Qwens egen Qwen-Image-Bench landar 2.1 på 60,28, strax över Googles Nano Banana 2.0 på 59,82. Google presenterade så sent som i februari Nano Banana 2 som sin bästa bildmodell. Siffrorna är Qwens egna och har inte upprepats av någon oberoende part, men de tidiga testerna som redan cirkulerar – och NyD:s egen genomkörning – pekar åt samma håll: en modell på sju miljarder parametrar med öppna vikter som kan köras hemma tar upp jakten på de stängda jättarna.
Egen dator i stället för stängt moln
Kontrasten mot de stängda bildtjänsterna är konkret. Där stannar vikterna på leverantörens servrar och användaren skickar text och bilder över nätet. Här landar parametrarna på den egna disken, och materialet behöver inte lämna maskinen.
Släppet ger ett öppet alternativ i praktiken. En student, en forskare eller den som bara vill testa hemma kan hämta vikterna, se parametrarna och köra själv, med samma slags funktioner som de stora molntjänsterna annars håller bakom egna gränssnitt.
För den som vill behålla bilderna på den egna datorn är skillnaden enkel: modellen körs där användaren själv väljer, på den hårdvara som redan står i rummet.
The next generation of Alibaba's Qwen Image 2.1 model is finally open-weight and out today. I had a chance to try it out before its release as one of fifty early access invitees on ModelScope and it certainly delivered. More to come soon! pic.twitter.com/cfRYPQWEre
Rörelsen i Qwen-familjen syns när släppen läggs i rad. Den ursprungliga Qwen-Image på 20 miljarder parametrar låg under Apache 2.0, som tillåter fri kommersiell användning. I februari 2026 kom Qwen-Image-2.0 som nästa generations bildmodell, men utan öppna vikter. Med 2.1 är vikterna tillbaka, nu i ett format som ryms på vanligare hårdvara. Mellan februari och söndagen saknades öppna vikter för den nyare bildgenerationen. Nu kan den som vill köra själv hämta en 7B-modell i stället för att vara hänvisad till den äldre 20-miljardersvarianten eller till en stängd molntjänst.
Det sker samtidigt som Alibaba använder öppenheten som strategisk hävstång. NyD har tidigare rapporterat att bolaget passerat tre miljarder nedladdningar av sina öppna AI-modeller, och att Qwen-familjen därmed ligger före både Meta och Google i Hugging Face-statistiken. I augusti öppnade bolaget dessutom vikterna till Qwen3.8, första gången en modell i Max-klassen släpptes öppet.
Bildmodellen passar in i det mönstret. Öppna vikter läggs ut att hämta, medan de stängda AI-jättarna håller motsvarande bildverktyg bakom egna molntjänster.
Vikterna ligger under Qwen Research License, daterad 20 september 2026. Rättighetsinnehavare är Hangzhou Tongyi Laboratory Technology Co., Ltd., och avtalet ger rätt att använda, kopiera, sprida och modifiera materialet endast för forskning och utvärdering; kommersiell användning kräver ett separat avtal.
Den som vill testa själv kan göra det på egen maskin redan nu. Vikterna är ute, och de vanligaste lokala verktygen tog emot dem samma dag.
Trovärdighet – grunden i vår journalistik sedan 2012
Nya Dagbladets position är unik i det svenska medielandskapet. NyD är oberoende på riktigt. Tidningen ägs och kontrolleras inom den egna redaktionen – inte av stora mediekonglomerat eller utländska intressen.
Sedan grundandet 2012 har grunden i vår oberoende journalistik varit balans och trovärdighet framför sensationsjournalistik och snabba klick. NyD är Sveriges bredaste helt oberoende dagstidning och står helt fri från politiska partier och industriintressen.
NyD erhåller inget presstöd och finansieras genom läsardonationer och annonser. Läs mer om våra pressetiska riktlinjer här.